

Gustavo é gerente de contas na eximia.co e cuida da conta da Acme. Seu principal contato lá é o João, gerente de TI. Gustavo quer ser apresentado ao Maurício, gerente de suprimentos da Acme, que ele ainda não conhece.
A resposta parece óbvia para qualquer um de nós: peça ao João que faça a ponte. Mas pare um instante na pergunta que interessa para quem constrói software: como um agente de IA chegaria a essa mesma conclusão?
A saída mais imediata seria jogar tudo no contexto da LLM. Nomes, empresas, cargos, quem fala com quem, e deixar o modelo deduzir o caminho. Para um exemplo deste tamanho, funciona. O problema aparece quando a rede cresce. Cada nova pessoa, cada novo relacionamento, vira mais texto na janela de contexto, mais tokens por chamada, mais custo. O que era trivial com cinco pessoas fica caro e instável com cinco mil.
A alternativa sensata é manter esse conhecimento fora da LLM e consultá-lo sob demanda. E é nesse ponto que quase todo time toma, por reflexo, a decisão que vai limitar a solução: alcança o banco relacional.
O banco relacional é a ferramenta default, e por bons motivos. Empresas, pessoas, cargos, relacionamentos: tudo isso modela bem em tabelas. Uma tabela de pessoas, uma de empresas, uma de vínculos. Para guardar quem é quem e quem se relaciona diretamente com quem, é difícil fazer melhor.
Só que o problema do Gustavo não é armazenar dados. É descobrir uma conexão. E descobrir conexões é um tipo de pergunta diferente de recuperar registros.
Encontrar o caminho entre Gustavo e Maurício é fácil com três pessoas. Em uma rede corporativa real, esse caminho pode atravessar cinco, dez, vinte relacionamentos.
No exemplo pequeno, a consulta é direta. Mas quando o caminho entre duas entidades tem profundidade desconhecida, o modelo relacional encosta no seu limite de projeto. Cada salto na cadeia de relacionamentos é mais um JOIN. Para um caminho de profundidade que você não conhece de antemão, não há um número fixo de JOINs que resolva. Você precisaria de consultas recursivas, e o custo cresce a cada nível.
Esse não é um defeito do banco relacional. É uma questão de adequação. Bancos relacionais foram desenhados para operações de conjunto e relações diretas, e são excelentes nisso. Para travessias de profundidade arbitrária, a literatura é consistente: o desempenho de consultas pode degradar à medida que o número de JOINs aumenta, porque o modelo resolve referências por junções a cada execução, em vez de seguir conexões diretamente.
Olhe a rede do Gustavo crescer. À esquerda, o exemplo do texto: três pessoas, um caminho óbvio. À direita, a mesma natureza de problema em escala corporativa, onde a ponte entre duas pontas atravessa vários intermediários que ninguém mapeou à mão.
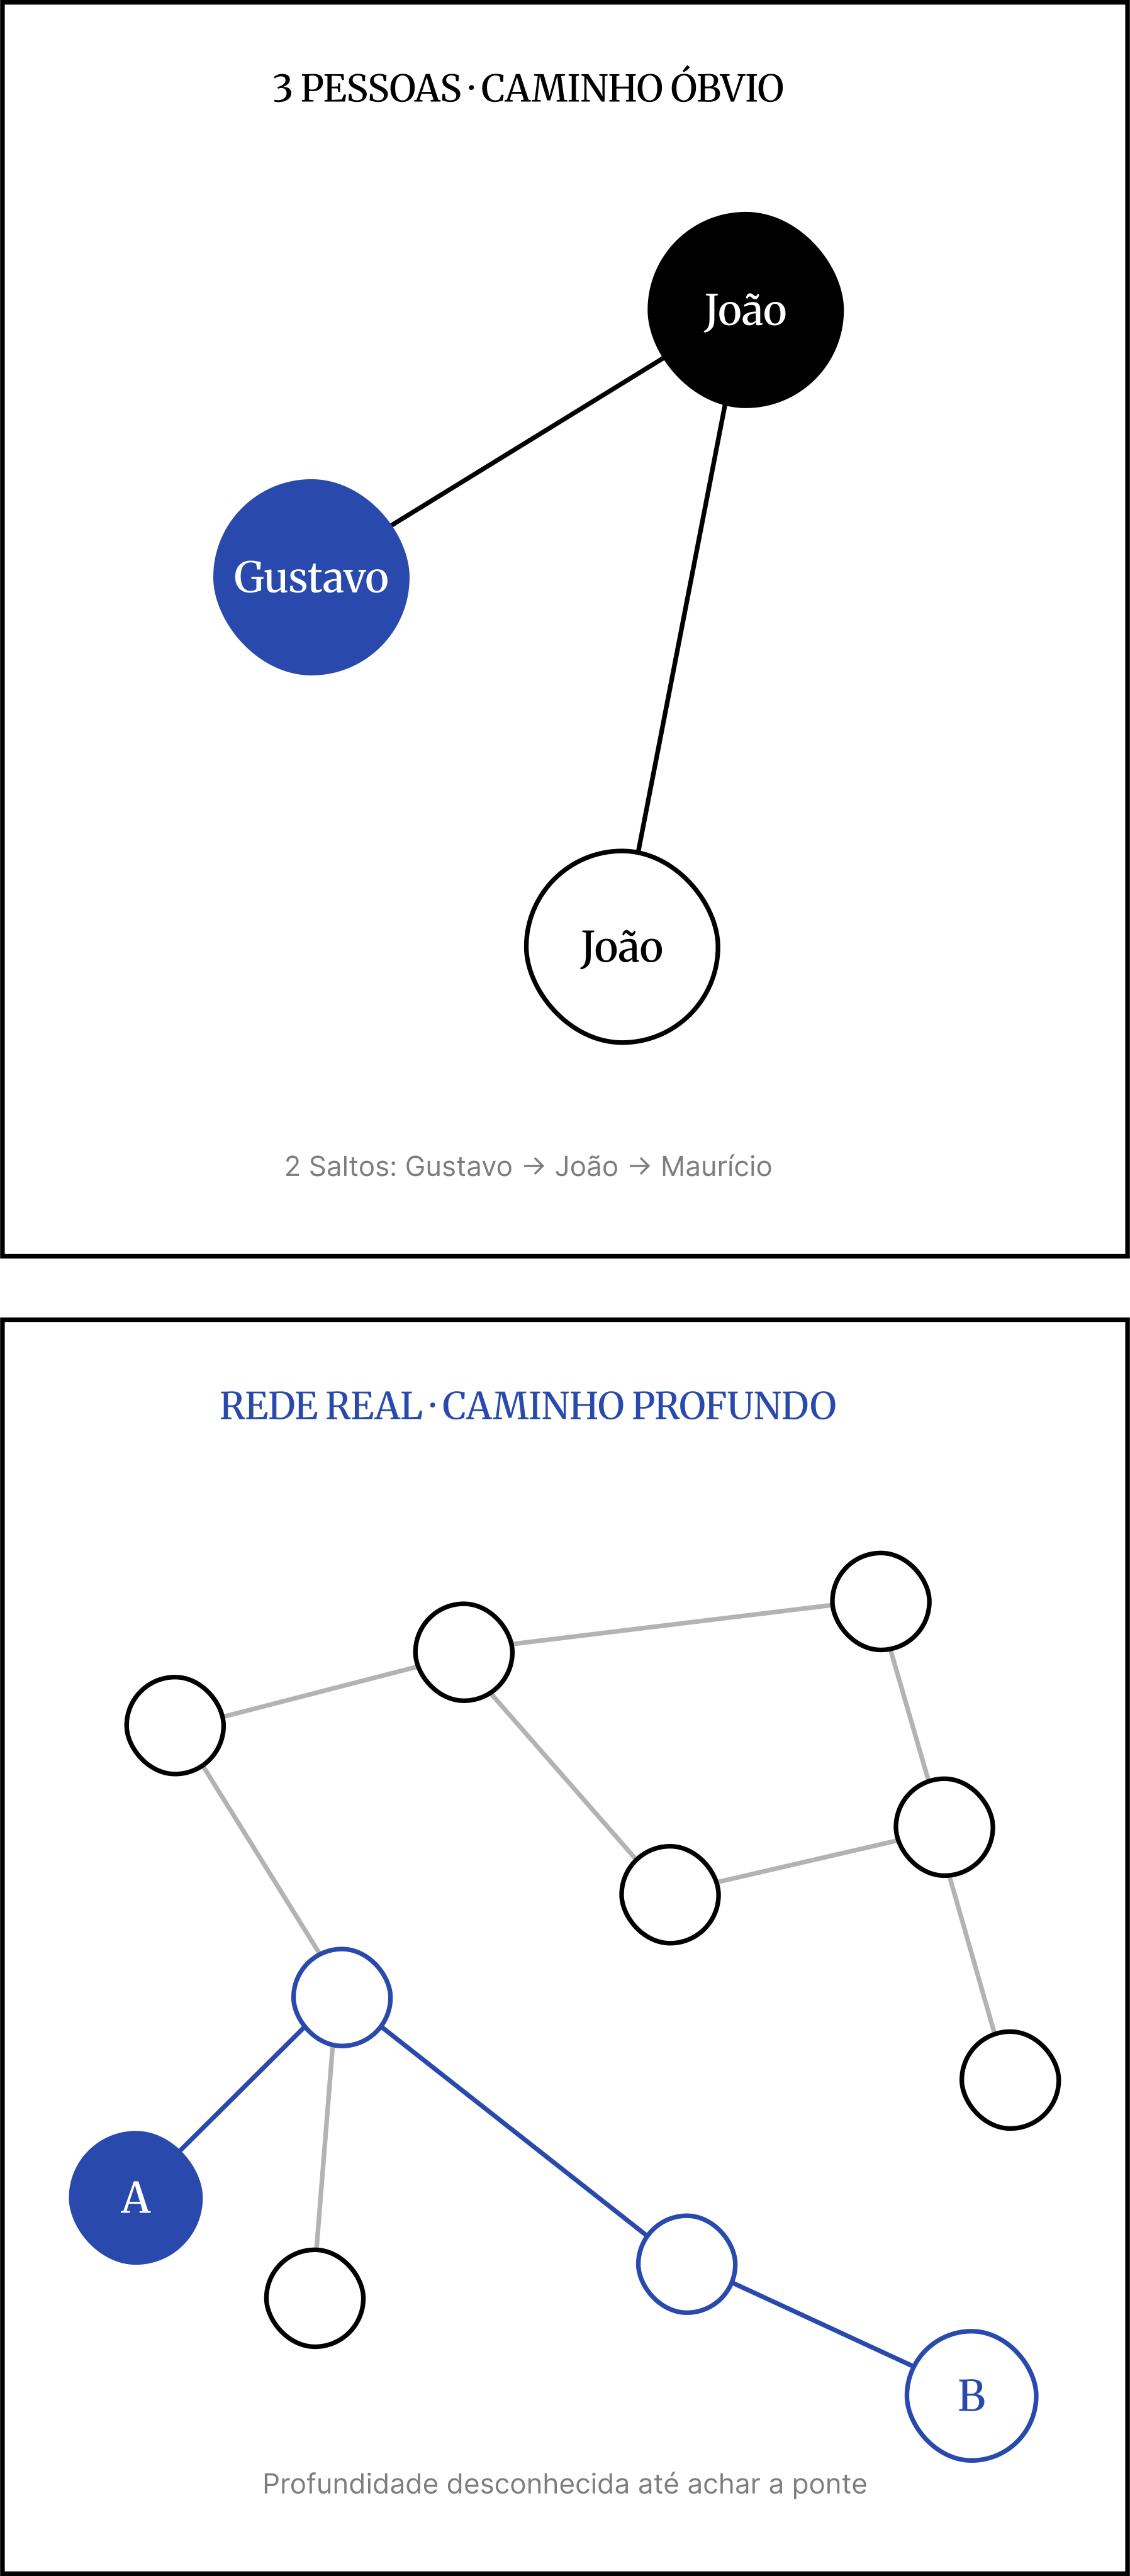
Um banco de grafos guarda as conexões como ligações diretas entre nós e as percorre seguindo essas ligações, sem reconstruir junções a cada salto. Por isso ele se sai bem justamente onde o relacional aperta: encontrar o menor caminho entre dois nós, atravessar profundidade variável, analisar redes de relacionamento. A documentação técnica é direta ao dizer que bancos de grafos podem superar os relacionais em consultas que envolvem muitas arestas ou profundidade desconhecida, sobretudo em análise de conexões e consultas recursivas.
Vale a honestidade técnica: isso não significa que grafo é sempre mais rápido. Há cenários em que o relacional, bem indexado, compete de igual para igual. O ponto não é velocidade absoluta, é adequação ao formato da pergunta. Quem decide arquitetura escolhe pela natureza do problema, não pela moda.
E há um segundo nível, que o grafo sozinho não cobre. Encontrar o caminho responde quem está conectado a quem. Mas a pergunta do Gustavo embute uma conclusão: dado o caminho, quem é a melhor pessoa para fazer a apresentação. Isso é dedução sobre as conexões, não apenas travessia. É o trabalho de um motor de inferência.
Três perguntas, três ferramentas. A régua é essa: classifique o que o sistema precisa responder antes de escolher onde guardar o dado. Recuperação, travessia e dedução são problemas distintos, e tratá-los todos como recuperação é o erro de arquitetura mais comum que vejo.
A solução do agente do Gustavo não é uma escolha entre LLM e banco. É a composição certa. A LLM interpreta o pedido em linguagem natural e redige a resposta. O grafo descobre o caminho entre Gustavo e Maurício. O motor de inferência conclui, a partir desse caminho e das regras do domínio, que João é a ponte mais curta e confiável. Cada camada faz o que faz bem, e o conhecimento de relacionamentos nunca precisa inchar a janela de contexto.
O ganho é o mesmo que defendi no texto anterior, agora aplicado à descoberta de conexões. A consulta ao grafo é barata e não cresce com o tamanho do prompt. A conclusão do motor é determinística e auditável: você consegue mostrar por qual caminho o agente chegou ao João. A LLM entra só na ponta, traduzindo intenção e redigindo. É arquitetura híbrida, com cada peça no lugar onde é forte.
Na eximia.co, escolher a estrutura certa para cada tipo de pergunta é trabalho corrente nas três frentes da casa. Nas consultorias, ajudamos a desenhar a arquitetura que separa recuperação, travessia e dedução em vez de empilhar tudo num banco só. Nas assessorias, acompanhamos os times implementando essas composições dentro dos próprios sistemas. Nas capacitações, formamos a liderança técnica para reconhecer, no projeto real, quando a pergunta deixou de ser sobre dados e passou a ser sobre conexões.
A Márcia mantém o conhecimento de relacionamentos em um grafo de conhecimento. Quando ela precisa de uma conexão que não está dita de forma direta, a conexão é descoberta pela travessia do grafo, e não reconstruída a cada chamada dentro da janela de contexto.
É exatamente o problema do Gustavo, resolvido na arquitetura certa. A pergunta sobre caminho vai para o grafo. A conclusão sobre o que fazer com esse caminho vai para o motor. A LLM da Márcia conversa. A estrutura da Márcia descobre e deduz.
Como tenho dito, arquitetura é escolher a ferramenta certa para o problema certo. E não é nada inteligente supor que a essência da inteligência artificial são LLMs. Quatro perguntas para fazer à sua arquitetura ainda esta semana.
Quais perguntas do seu sistema são, no fundo, sobre descobrir caminhos, e não sobre recuperar registros?
Onde você está resolvendo travessia de profundidade desconhecida com JOINs recursivos que crescem sem teto?
Quanto conhecimento de relacionamento você joga na janela de contexto a cada chamada, em vez de consultar uma estrutura própria?
Na sua arquitetura, recuperação, travessia e dedução usam a mesma ferramenta, ou cada uma usa a que foi feita para ela?
- Neo4j · 2025. Graph Database vs. Relational Database: What’s the Difference. Sobre a degradação de desempenho com o aumento de JOINs e travessia por ligações diretas. neo4j.com
- Microsoft Learn · 2026. Graph and Relational Database Comparison. Sobre grafos superarem relacionais em consultas com muitas arestas ou profundidade desconhecida. learn.microsoft.com
- AWS. Graph vs Relational Databases: Difference Between Databases. Sobre o custo de resolver referências por JOIN quando o número de conexões é grande ou desconhecido. aws.amazon.com
- MDPI Applied Sciences · 2022. Performance of Graph and Relational Databases in Complex Queries. Sobre o contraponto: relacionais bem ajustados competem em certos cenários complexos. mdpi.com/2076-3417/12/13/6490

Vamos entender o próximo passo juntos?
Fale com um especialista da eximia.co sobre arquitetura, engenharia e tecnologia.


