

Registrar o que se sabe do mundo por meio de fatos. Maria é mãe de João e filha de Ana. O carro X tem o freio Y, que contém a peça Z. A partir daí, inferir, por regras, relações que ninguém escreveu à mão. Ana é avó de João. A peça Z está no carro X.
Isso é mais do que dados soltos. São fatos conectados, com relações explícitas e relações descobertas por dedução. É informação com utilidade. É conhecimento. E é exatamente esse o trabalho que, em boa parte das soluções de IA que vejo hoje, foi terceirizado por inteiro para o modelo de linguagem.
O sintoma aparece primeiro na conta. Toda regra de domínio que poderia ser deduzida em microssegundos é jogada dentro da janela de contexto e repassada à LLM a cada chamada. O modelo relê as mesmas premissas, refaz a mesma cadeia lógica e cobra tokens por isso, todas as vezes. O contexto incha, a latência sobe, o custo de inferência acompanha. E o pior nem é o preço.
O pior é que a conclusão não é confiável. Um modelo de linguagem não deduz que Z está no carro X. Ele gera a sequência de tokens estatisticamente mais provável dado o prompt. Na imensa maioria das vezes acerta. Em uma fração das vezes, com a mesma fluência e a mesma confiança, erra. E você não tem como saber qual foi qual, porque não há cadeia de derivação para auditar. Há um texto plausível.
Quando todo o raciocínio do domínio mora dentro do modelo, você paga caro para receber um palpite muito bem escrito.
A literatura técnica já nomeia isso sem rodeios. Modelos de linguagem alucinam e exibem instabilidade mesmo em configurações supostamente determinísticas, e contêm passos de raciocínio inválidos que comprometem transparência e explicabilidade. Em domínios de alto risco, isso não é um detalhe de implementação. É o problema.
O problema é novo na embalagem, não na essência
A engenharia já resolveu esse problema antes, décadas antes de existir LLM. A categoria tem nome: motor de inferência. Uma estrutura que guarda fatos, aplica regras e deduz relações novas de forma determinística. Mesma entrada, mesma saída, sempre, com a cadeia de derivação disponível para inspeção.
O exemplar mais didático dessa categoria é o Prolog. Uma linguagem declarativa cujo coração é justamente um motor de inferência, criada para representar conhecimento e deduzir relações. Você declara fatos e regras, e o motor responde consultas por unificação e resolução. Não é novidade: existe desde 1972 e nunca deixou de ser usado em sistemas especialistas, representação de conhecimento e raciocínio automatizado.
					% Fatos. O que sabemos do mundo.
mae(maria, joao).
filha(maria, ana).
contem(freio_y, peca_z).
tem_componente(carro_x, freio_y).

% Regras. Como deduzir o que ninguem escreveu.
avo(A, N)      :-  filha(M, A), mae(M, N).
esta_em(P, C)  :-  contem(S, P), tem_componente(C, S).

% Consulta. Deterministica, auditavel, barata.
?- avo(ana, joao).          % true
?- esta_em(peca_z, X).       % X = carro_x
O ponto não é adotar Prolog. É reconhecer que motor de inferência é uma categoria arquitetural, e Prolog é apenas uma de suas instâncias. Há outras, com a mesma natureza declarativa. Um banco de grafos é a mais óbvia.
Quem já olhou para uma consulta em grafo percebe o parentesco imediato. A regra de avó em Prolog e a mesma travessia em Cypher são, no fundo, a mesma ideia: você descreve o padrão de relações que procura, e o motor encontra o caminho. Não é coincidência que engenheiros que constroem memória para agentes descrevam regras de inferência como consultas Cypher parametrizadas, observando que ambos são fundamentalmente declarativos.
					// Os mesmos fatos viram nos e arestas.
MATCH (s)-[:CONTEM]->(p:Peca)
MATCH (c:Carro)-[:TEM_COMPONENTE]->(s)
WHERE p.nome = 'peca_z'
RETURN c.nome      // o motor traca o caminho ate o carro
Prolog e grafos são primos. Famílias diferentes do mesmo motor. O que importa para a arquitetura não é qual deles você escolhe, e sim que exista algum motor de inferência no sistema, fora da LLM, fazendo o trabalho determinístico que a LLM faz mal e caro.
E essa não é uma intuição isolada. É a tese central de uma corrente inteira de pesquisa. A IA neuro-simbólica passou de curiosidade acadêmica a consideração de produção ao longo de 2025, com a divisão de trabalho explícita: redes neurais para percepção e linguagem, camadas simbólicas para dedução lógica, imposição de restrições e auditabilidade.
Onde deveria morar esse raciocínio?
Antes de falar de solução, vale fixar o critério. Diante de qualquer relação que seu sistema precise concluir, pergunte por quatro propriedades. Elas separam o que deve ser deduzido por um motor do que pode ser delegado a um modelo.
A régua é simples de aplicar. Se a relação é derivável de regras, ela não pertence à janela de contexto. Pertence a um motor que a deduz de forma determinística, barata e auditável. Deixar isso na LLM é pagar preço de modelo de fronteira para fazer o que um sistema de 1972 já fazia melhor.
Cada um no seu papel
A arquitetura que passa na régua é híbrida, e a divisão de trabalho é limpa. A LLM faz o que faz bem: interpreta linguagem ambígua, traduz a intenção do usuário em consultas, redige a resposta final em texto natural. O motor de inferência faz o que faz bem: guarda o conhecimento do domínio e deduz, com rigor, as relações que decorrem dele.
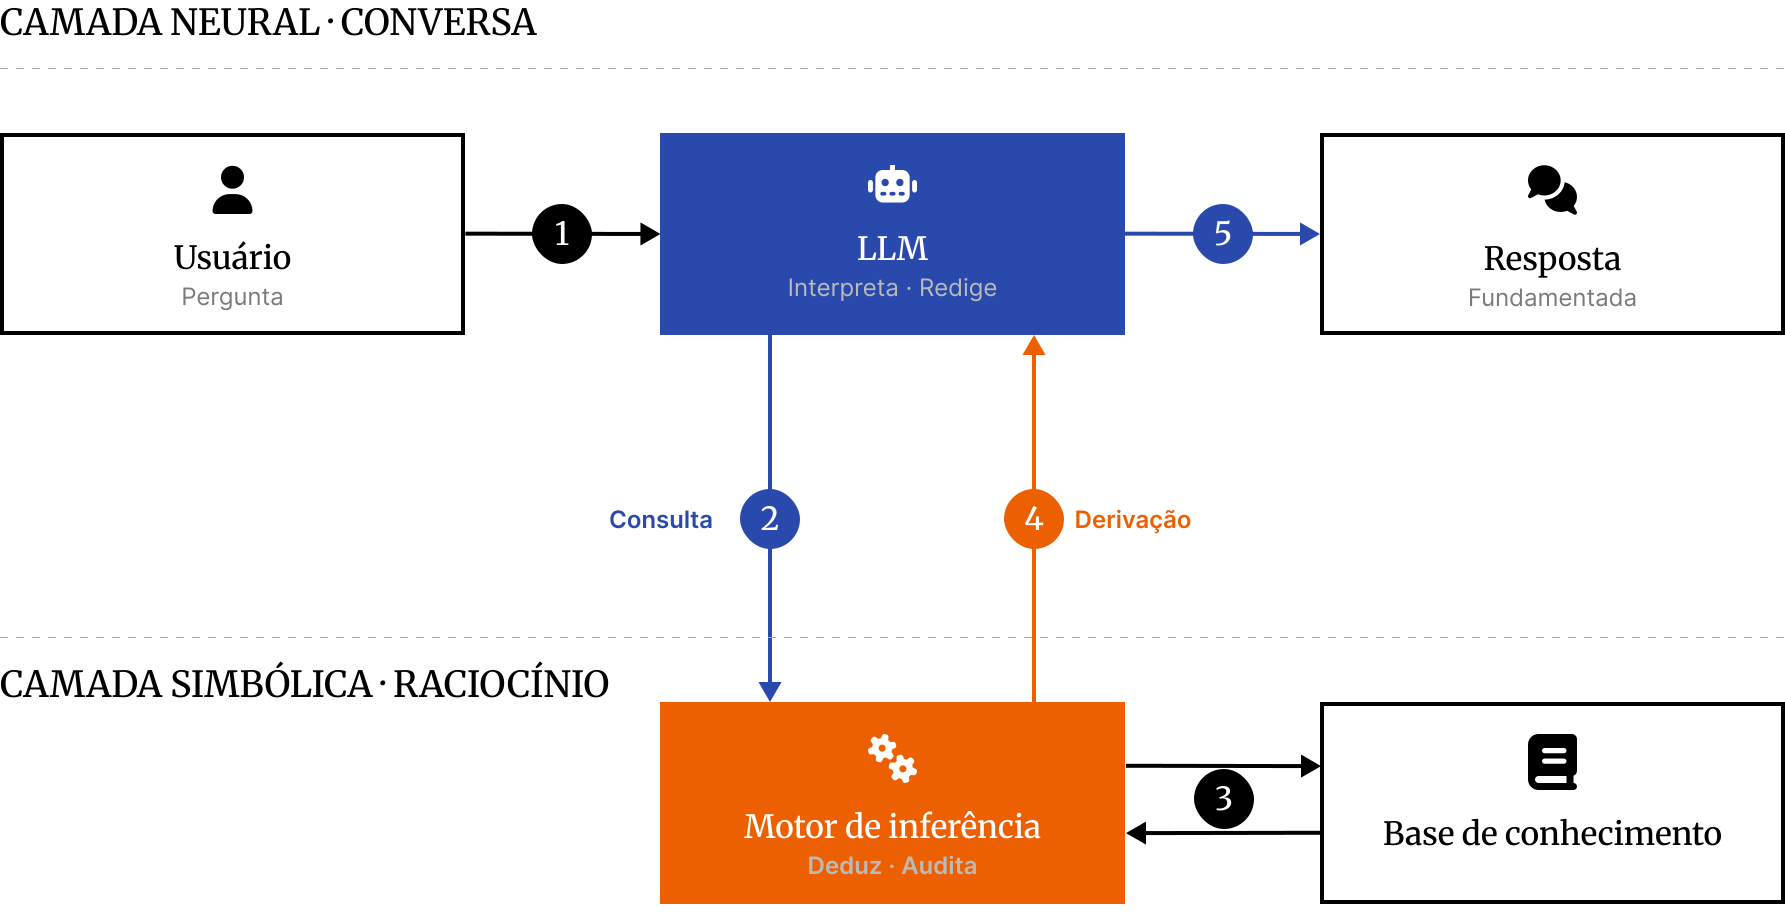
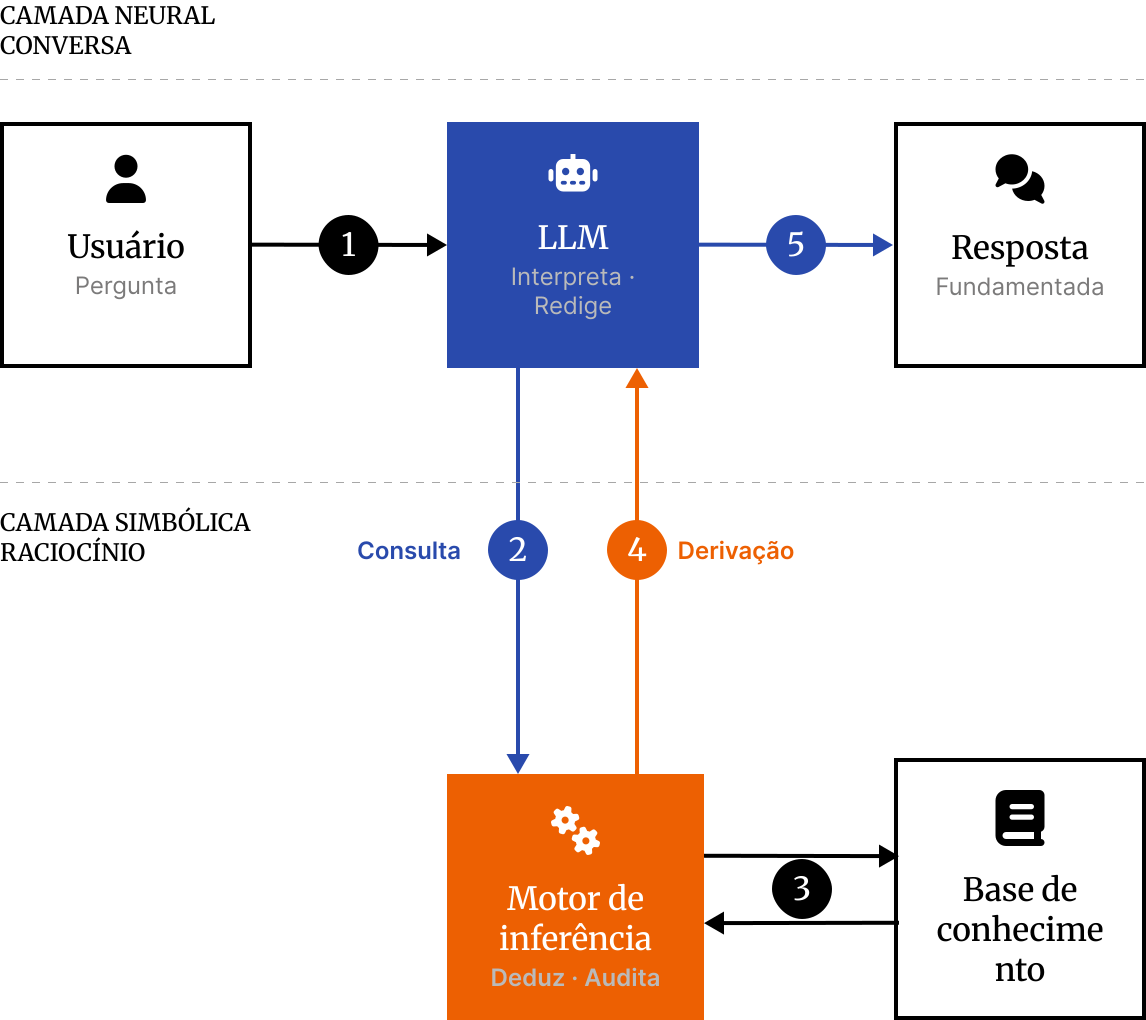
Note o que muda no fluxo. A LLM não carrega mais todas as regras do domínio dentro de si a cada chamada. Ela formula uma consulta ao motor, recebe uma conclusão determinística com sua derivação, e usa isso para redigir. A inferência saiu da janela de contexto. Onde antes havia token e torcida, passa a haver dedução barata, precisa e auditável.
É a mesma lógica que pesquisadores descrevem como executar o raciocínio fora da janela de tokens da LLM, combinando o controle determinístico do lado simbólico com a conversa probabilística do lado neural. Cada camada faz aquilo para o qual foi feita.
Isso não é teoria de slide
Na eximia.co, motor de inferência não é tema de palestra. É território onde operamos nas três frentes da casa. Nas consultorias, é o componente arquitetural com que tratamos a separação entre o que a LLM conversa e o que uma estrutura deve deduzir. Nas assessorias, ajudamos os times a implementar essa arquitetura híbrida dentro dos próprios sistemas, com a base de conhecimento no lugar certo. Nas capacitações, ensinamos os fundamentos para que a liderança técnica reconheça, no projeto real, onde o raciocínio escapou para dentro do modelo.
Uma masterclass recente foi exatamente isso na prática: fundamentos de modelagem de conhecimento com Prolog, do fato e da regra à consulta auditável. Não porque vamos colocar Prolog em produção no cliente, mas porque quem entende como um motor de inferência pensa enxerga, no projeto real, o trabalho que a LLM está fazendo e não deveria.
Esse repertório aparece no nosso trabalho com grafos de conhecimento e na forma como tratamos memória de agentes. Que nos leva ao case mais concreto que temos para mostrar.
A Márcia tem, na memória semântica, um grafo de conhecimento em Neo4j. Esse grafo não é um arquivo morto de onde ela copia trechos. É um motor: quando ela precisa de uma relação que decorre do que já sabe, a relação é deduzida pela travessia do grafo, não inventada na janela de contexto.
O efeito prático é o da régua inteira de uma vez. A conclusão é determinística, tem caminho rastreável, não consome tokens proporcionais ao tamanho do domínio e não se distrai com prompt longo. A LLM da Márcia conversa. O grafo da Márcia raciocina.
Pegue uma regra de elegibilidade qualquer. Cliente elegível se contrato ativo, sem pendência aberta e dentro da carência. No modelo ingênuo, as três condições e os dados de cada cliente vão para o prompt, e a LLM “decide” a cada chamada, pagando tokens e oferecendo um veredito que você não consegue auditar.
No modelo com motor, elegibilidade é uma regra declarada uma vez. O motor consulta os fatos, deduz o resultado e devolve a derivação: elegível porque contrato ativo, sem pendência, dentro da carência. Barato, igual em toda execução, e defensável diante de uma auditoria. A LLM só precisa explicar o resultado em português para o usuário.
Quem leva IA a sério já separou as camadas
Isso deixou de ser aposta de nicho. Em 2025 a abordagem chegou a operações de grande porte. A Amazon incorporou IA neuro-simbólica a robôs de armazém e ao assistente de compras Rufus justamente para elevar precisão e qualidade de decisão. Em controle de processos industriais, frameworks combinam programação lógica para avaliar a coerência das explicações geradas por LLMs, tratando alucinação como falha de raciocínio a ser barrada por uma camada simbólica.
O fio comum a todos esses sistemas é o mesmo princípio de arquitetura: determinismo e garantias formais onde o risco é mais alto, flexibilidade neural onde é preciso conversar com gente. Não é a LLM contra o motor de inferência. É a LLM com o motor de inferência, cada um no lugar onde é forte.
Não é nada inteligente supor que a essência da inteligência artificial são LLMs.
LLMs são uma camada extraordinária. São a melhor interface de linguagem natural que já construímos. Mas confundir a camada de conversa com a totalidade da inteligência artificial é um erro de arquitetura que se paga em token, em alucinação e em sistemas que ninguém consegue auditar. O repertório de quem leva IA a sério, para além da moda, inclui saber quando o raciocínio deve sair do modelo.
As perguntas que separam dedução de palpite
A próxima etapa da IA não será vencida por quem conversa melhor com os modelos. Será vencida por quem estrutura melhor o conhecimento que esses modelos acessam, e sabe o que pode ser deduzido fora deles. Quatro perguntas para fazer à sua arquitetura ainda esta semana.
Quais relações o seu sistema conclui hoje dentro da LLM que, na verdade, são deriváveis de regras?
Quando uma conclusão do seu agente é questionada, você consegue mostrar a cadeia de derivação ou apenas o texto que ele gerou?
Quanto do seu custo de tokens é raciocínio de domínio repetido a cada chamada, que um motor faria uma vez e de graça?
Na sua arquitetura, quem carrega o conhecimento do domínio: a LLM, ou uma estrutura feita para deduzir sobre ele?
Se a resposta da última pergunta for “a LLM”, você já encontrou onde sua próxima rodada de eficiência, confiabilidade e auditabilidade está esperando. É aí que a gente trabalha.
- arXiv · 2025. ATA: A Neuro-Symbolic Approach to Implement Autonomous and Trustworthy Agents. Sobre instabilidade e passos de raciocínio inválidos em LLMs. arxiv.org/html/2510.16381v1
- Medium · 2025. Kobi Toueg, Prolog: The Forgotten Language That Powers Legal Tech and AI. Sobre Prolog desde 1972, unificação e resolução. medium.com
- DEV · 2025. Building a Prolog-Inspired Inference Engine for AI Coding Agents. Sobre regras de inferência como consultas Cypher parametrizadas. dev.to
- Zylos Research · 2026. Neuro-Symbolic AI for Agent Reasoning. Sobre a transição da abordagem para produção ao longo de 2025. zylos.ai
- arXiv · 2024. Cognition is All You Need: The Next Layer of AI Above Large Language Models. Sobre executar o raciocínio fora da janela de tokens. arxiv.org/pdf/2403.02164
- Medium · 2025. Greg Robison, Neuro-Symbolic AI: A Foundational Analysis of the Third Wave’s Hybrid Core. Sobre a adoção pela Amazon em robôs de armazém e no Rufus. gregrobison.medium.com
- MDPI Processes · 2026. Neuro-Symbolic Verification for Preventing LLM Hallucinations in Process Control. Sobre programação lógica avaliando a coerência de explicações geradas por LLMs. mdpi.com/2227-9717/14/2/322

Vamos entender o próximo passo juntos?
Fale com um especialista da eximia.co sobre arquitetura, engenharia e tecnologia.
