

Tech Leads raramente se tornam gargalos por falta de competência. Isso acontece quando a operação depende do que apenas eles sabem, percebem ou conseguem resolver. Sem clareza sobre como o trabalho realmente avança, atividade parece entrega, pressa parece fluxo e presença parece controle.
Quando um líder competente deixa de enxergar a operação
Em uma reunião de diagnóstico, diante de um grande cliente, os dados de um time de engenharia apareceram pela primeira vez para as pessoas que conduziam a operação. Eles contrariavam a percepção da sala. O fluxo era mais lento, o retrabalho mais presente e a entrega menos regular do que a narrativa cotidiana fazia parecer.
O primeiro impulso foi rejeitar os números. Questionar a coleta. Defender o time. Pedir que a análise fosse refeita. Era uma reação compreensível. Quando um dado ameaça a história na qual um grupo se apoia, atacar o mensageiro parece mais seguro do que revisar a história.
O Tech Lead permaneceu calado durante boa parte da discussão. Quando recebeu a palavra, começou de um jeito que ninguém esperava:
Eu queria dizer que estou com vergonha.
Depois da pausa, ele explicou que a vergonha não vinha de uma acusação contra o time. Vinha de não ter visibilidade daqueles problemas. Ele reconheceu que conduzia uma operação cujo comportamento real não conseguia acompanhar e pediu a oportunidade de mudar essa condição.
A frase mudou a reunião porque trocou defesa por investigação. O dado deixou de ser uma sentença sobre pessoas e passou a abrir perguntas sobre a forma de trabalho. O líder não abriu mão do contexto nem aceitou cada número como verdade absoluta. Ele apenas fez a escolha mais difícil da liderança técnica: preferiu enxergar a se proteger.
Essa cena ajuda a desmontar uma caricatura. Liderar no escuro não é defeito exclusivo de um chefe despreparado. Acontece com gente competente, responsável e bem-intencionada. Acontece quando o cotidiano ocupa todo o campo de visão.
Às vezes, essa condição assume a forma do herói. É a pessoa que resolve o bug impossível, responde a qualquer hora, guarda o contexto mais importante e destrava toda decisão difícil. O time gosta dela porque sua presença reduz a ansiedade imediata. A organização gosta porque, enquanto o herói aguenta, os problemas parecem desaparecer.
Em outros casos, assume a forma do Tech Lead soterrado. Ele não centraliza por vaidade. Centraliza porque a agenda está cheia, o contexto é fragmentado e as urgências chegam mais rápido do que a capacidade de estruturar o trabalho. Aos poucos, reage mais e observa menos. A liderança vira uma sequência de decisões locais tomadas sob pressão.
Nos dois casos, a perda de visibilidade gera um ciclo. Como os problemas não aparecem com antecedência, o líder precisa intervir pessoalmente. Como ele intervém pessoalmente, o time deixa de desenvolver referências e mecanismos próprios. Como esses mecanismos não existem, a presença do líder se torna ainda mais necessária.
O problema não é falta de talento. É uma operação que só funciona porque alguém compensa o que o time ainda não consegue enxergar.
O preço de liderar por percepção
Pouca visibilidade sobre a operação de engenharia muda a forma como o trabalho flui, como as decisões são tomadas e como o time aprende. Seu custo aparece em pelo menos seis problemas conectados.
Centralização do contexto
Em uma daily, só o Tech Lead sabe qual entrega ameaça a data. No planejamento, só ele relaciona uma decisão recente ao risco de arquitetura. Durante um incidente, só ele lembra por que determinada restrição existe. As informações podem estar espalhadas em tickets, documentos e conversas, mas a conexão entre os fatos vive na cabeça de uma pessoa.
O efeito aparece nas perguntas recorrentes: o que entra agora, o que pode esperar, quem precisa revisar, qual risco é aceitável? Em vez de avançarem por critérios compartilhados, essas decisões entram na fila do líder. Ele deixa de atuar apenas nas escolhas de maior consequência e passa a traduzir o cotidiano para o restante do time.
Senioridade deve concentrar decisões difíceis, não todas as decisões. Quando até o trabalho recorrente precisa da interpretação da mesma pessoa, o problema não é excesso de confiança no líder. É ausência de referências comuns.
Dependência operacional
Sem uma leitura comum da entrega, o time espera pela interpretação do líder. Qual item priorizar? Quando um bloqueio virou exceção? Uma mudança precisa de revisão adicional? A qualidade está se deteriorando ou foi apenas uma semana ruim? Se as respostas dependem sempre da mesma pessoa, autonomia vira permissão.
O time pode parecer independente enquanto tudo segue o esperado. A dependência aparece diante da ambiguidade. É nesse momento que todos procuram quem carrega o mapa mental da operação.
Gestão por impressão
O cérebro humano conta histórias convincentes a partir do que viu por último. Um incidente recente faz a qualidade parecer ruim. Uma semana produtiva faz a capacidade parecer maior. A pessoa mais vocal parece sobrecarregada. A mais silenciosa parece tranquila. O componente que deu problema ontem recebe atenção mesmo que outro concentre muito mais risco.
Percepção é inevitável e útil. O erro é tratá-la como linha de base. Sem sinais comparáveis ao longo do tempo, não há como distinguir padrão de exceção, tendência de ruído ou causa de sintoma.
Descoberta tardia
Filas, retrabalho e risco técnico raramente surgem de uma vez. Eles se acumulam. Um item espera revisão por alguns dias. Uma janela de release aumenta o lote. Uma área do código recebe mudanças recorrentes sem proteção proporcional. O conhecimento de um fluxo crítico se concentra numa pessoa.
Quando esses sinais não são acompanhados, o problema só recebe nome depois do dano. A fila vira atraso. O lote vira incidente. A concentração vira indisponibilidade quando alguém sai de férias. A dívida vira projeto urgente quando uma mudança de negócio encontra uma estrutura incapaz de contê-la.
Otimização local
Quando cada parte da operação é vista isoladamente, respostas simples parecem suficientes. Se a entrega está baixa, cobra-se mais atividade. Se o cycle time está alto, pressiona-se quem executa. Se há bugs, acrescenta-se uma etapa de aprovação. Cada resposta pode parecer razoável sozinha e ainda assim piorar o resultado do time.
A Teoria das Restrições, desenvolvida por Eliyahu Goldratt, oferece uma lente precisa para esse problema: o resultado de uma operação é limitado por sua principal restrição. Se uma etapa que não é o gargalo passa a produzir mais, a entrega do conjunto não acelera; o trabalho apenas chega mais rápido à restrição. O caminho é identificar a restrição, aproveitar melhor sua capacidade, subordinar o restante do trabalho ao seu ritmo e, somente depois, ampliá-la.
Essa relação entre acúmulo e espera não é apenas uma metáfora de gestão. A Teoria das Filas nasceu dos estudos de Agner Krarup Erlang sobre o congestionamento no tráfego telefônico, iniciados em 1909. Em 1961, John D. C. Little demonstrou a relação L = λW: a quantidade média de itens em andamento é igual à taxa média de saída multiplicada pelo tempo médio que cada item permanece no fluxo. Portanto, enquanto a vazão continuar limitada pela restrição, aumentar o trabalho em andamento amplia principalmente o tempo de espera, não a entrega.
Na operação de engenharia, a restrição costuma se tornar visível na passagem entre etapas do fluxo. Quando o time coloca em andamento mais itens do que revisão de código, testes, homologação ou implantação conseguem absorver, o board mostra muita atividade sem que a entrega avance no mesmo ritmo. Os itens de trabalho se acumulam antes da etapa que limita o fluxo, o tempo de espera cresce e o Cycle Time se alonga.
O acúmulo em uma coluna é um sinal para investigação, não um diagnóstico automático. Uma fila em revisão de código, por exemplo, pode ser provocada pela falta de revisores, por mudanças grandes demais ou por um componente que concentra dependências e conhecimento. Adicionar uma nova aprovação sem localizar a origem das falhas cria outra etapa de espera. Pressionar quem atua no componente mais acoplado trata como deficiência individual uma restrição produzida pelo design.
Começar mais trabalho não remove o gargalo. Só aumenta a fila diante dele.
Dependência técnica
O código também registra a forma como a organização trabalha. Áreas alteradas sempre pelas mesmas pessoas revelam concentração de conhecimento. Arquivos que mudam juntos repetidamente revelam dependências práticas. Componentes muito alterados e muito dependidos concentram custo e risco.
O diagrama de arquitetura mostra as fronteiras que pretendíamos construir. O histórico de mudanças mostra as fronteiras que funcionam na prática. Dois componentes podem estar separados no repositório e ainda exigir alterações, revisões e deploys coordenados quase sempre. Quando a intenção e o comportamento divergem, a liderança paga em coordenação o desacoplamento que existe apenas no diagrama.
O mecanismo que conecta os seis problemas
Centralização do contexto, dependência operacional, gestão por impressão, descoberta tardia, otimização local e dependência técnica não são falhas independentes. Elas se reforçam.
Quando o avanço do trabalho, as filas, as exceções e o risco técnico não são legíveis, as decisões passam a depender da percepção. A percepção concentra a interpretação em poucas pessoas. A centralização atrasa a resposta e impede que o time desenvolva referências próprias. Quando a resposta chega tarde, a mudança custa mais, envolve mais risco e exige novamente a presença do líder. O ciclo então recomeça.
Pouca visibilidade da operação → decisões por impressão → centralização → reação tardia → mudanças mais caras e arriscadas → maior dependência do líder.
Essa sequência muda a pergunta. Em vez de tentar corrigir cada sintoma isoladamente, precisamos compreender quais condições mantêm o ciclo funcionando. Antes de propor um método para interrompê-lo, vale verificar se essa leitura também encontra respaldo nas pesquisas sobre entrega, cultura e código.
O que o mercado e a literatura já mostram
Três linhas de pesquisa ajudam a explicar por que o desempenho da engenharia não pode ser deduzido apenas do esforço ou do talento individual. O DORA observa a entrega de software. Westrum investiga como organizações lidam com informação. Bird e colegas analisam como o ownership do código se relaciona com falhas. Os objetos são diferentes, mas todos deslocam a atenção do herói para as condições em que o trabalho acontece.
Entrega: DORA e as capacidades de entrega
O programa de pesquisa DORA tornou o desempenho da entrega mensurável por meio de indicadores de throughput e instabilidade. O modelo evoluiu das quatro métricas históricas para cinco métricas. Hoje, observa change lead time, frequência de deploy, tempo de recuperação de um deploy malsucedido, change failure rate e deployment rework rate.
A contribuição mais importante não está na quantidade de indicadores. O DORA mostra que velocidade e estabilidade não precisam ser objetivos rivais. A orientação oficial também é explícita sobre contexto: as métricas funcionam melhor no nível de uma aplicação ou serviço e não devem virar meta isolada, competição entre times ou comparação entre realidades incompatíveis.
Medir serve para estabelecer uma linha de base, localizar fricção, escolher uma restrição e verificar se a entrega melhorou. Essa perspectiva desloca a pergunta de “quem parece produzir mais?” para “quais condições favorecem ou impedem o fluxo de mudanças?”. Lotes menores, feedback rápido, automação e responsabilidade compartilhada afetam a maneira como uma mudança chega à produção.
Cultura: Westrum e o fluxo de informação
No artigo acadêmico A typology of organisational cultures, publicado em 2004 no Quality & Safety in Health Care, Ron Westrum propôs uma tipologia baseada em como organizações processam informação, sobretudo quando aparecem sinais de problema.
O trabalho distingue culturas patológicas, orientadas a poder, burocráticas, orientadas a regras, e generativas, orientadas ao desempenho. Westrum argumenta que o fluxo de informação é ao mesmo tempo influente e indicativo de outros aspectos culturais. Por isso, ajuda a antecipar como uma organização reagirá quando surgirem sinais de dificuldade.
Para a liderança técnica, a consequência é concreta. Se uma notícia ruim ameaça quem a traz, o problema aparece tarde. Se a informação atravessa silos antes de chegar a quem pode agir, a resposta chega tarde. Se erros iniciam investigação em vez de busca por culpados, o trabalho gera aprendizado.
A contribuição de Westrum não é ensinar a construir dashboards. É mostrar que fazer a informação certa chegar cedo às pessoas capazes de agir é uma capacidade operacional.
Métricas só melhoram decisões quando a cultura permite discutir o que elas revelam. Sem essa condição, números podem existir e o aprendizado continuar bloqueado.
Código: Bird e a distribuição do ownership
No artigo Don’t Touch My Code! Examining the Effects of Ownership on Software Quality, apresentado na ESEC/FSE de 2011, Christian Bird, Nachi Nagappan, Brendan Murphy, Harald Gall e Premkumar Devanbu estudaram a relação entre medidas de ownership e falhas em dois grandes produtos comerciais: Windows Vista e Windows 7.
O resultado é mais preciso do que “muitos autores geram defeitos”. Os autores encontraram relação entre falhas antes e depois do release e medidas como a quantidade de contribuidores com baixa experiência específica no componente e a proporção de mudanças concentrada no principal owner. O número bruto de pessoas que tocaram o código explica menos do que a distribuição do conhecimento sobre aquele código.
Isso produz dois riscos opostos. De um lado, conhecimento concentrado em uma única pessoa cria dependência e baixa continuidade. Do outro, contribuição muito fragmentada, sem alguém capaz de proteger a coerência do componente, dilui responsabilidade. A posição saudável não é exclusividade nem abertura irrestrita. É ownership reconhecível com capacidade distribuída.
O estudo não autoriza transformar autoria em julgamento de pessoas. Foi realizado em um contexto específico, e colaboração legítima pode produzir muitos autores. Sua força está em demonstrar que a qualidade possui uma dimensão social que o repositório ajuda a tornar visível. Se o código funciona como memória coletiva da engenharia, o mapa de contribuições revela ao mesmo tempo responsabilidade, dependência e risco de continuidade.
IA: mais produção local não garante mais fluxo
Ferramentas de IA tornam várias tarefas de construção de software mais rápidas. Mas reduzir o tempo de uma atividade local não remove automaticamente filas de revisão, dependências entre áreas, testes tardios, janelas de release, prioridades conflitantes ou decisões que esperam autorização.
A pesquisa recente do DORA ajuda a fundamentar essa distinção. O relatório de 2024 encontrou ganhos percebidos de produtividade, sensação de fluxo e satisfação individual, mas associações negativas com throughput e estabilidade da entrega. O próprio relatório levantou a hipótese de que maior velocidade de geração poderia ampliar lotes e exigir mais dos mecanismos de teste e feedback.
No relatório de 2025, a associação com throughput mudou de direção, mas veio acompanhada de maior instabilidade. A síntese do estudo descreve a IA como um amplificador: ela amplia tanto as forças quanto as fragilidades já presentes na organização. As duas edições não provam que IA causa esses resultados, mas convergem num ponto importante.
Quanto mais barato fica produzir uma alteração, mais importante se torna acompanhar lote, filas, estabilidade e capacidade de revisão. Sem essa leitura, a organização pode celebrar produção enquanto amplia retrabalho e coordenação.
O que as evidências mostram em conjunto
DORA mostra que throughput e estabilidade precisam ser observados em conjunto e interpretados no contexto da entrega. Westrum mostra que a informação precisa atravessar fronteiras sem punição para produzir aprendizado. Bird mostra que a distribuição do conhecimento e do ownership participa do risco do software. A pesquisa sobre IA acrescenta que acelerar a produção local pode ampliar tanto as capacidades quanto as fragilidades já presentes na organização.
Embora observem objetos diferentes, os estudos apontam para o mesmo teste prático: produzir mais individualmente só gera valor quando o trabalho atravessa o fluxo e se transforma em entrega. Para isso, o time precisa enxergar onde o trabalho espera, receber feedback antes que o lote cresça, compartilhar o conhecimento crítico e agir sobre exceções sem aguardar sempre a intervenção do líder.
Alta performance não é a soma de atos heroicos. É a capacidade de entregar, aprender e corrigir sem depender de um herói.
A régua para uma boa liderança técnica
Se a entrega sustentável depende da forma como a engenharia trabalha, precisamos de uma referência para avaliar se cada escolha técnica melhora a capacidade de mudar o software ao longo do tempo. Na eximia.co, essa referência parte de um objetivo simples:
O objetivo da boa Engenharia de Software é reduzir o custo e o risco da mudança ao longo do tempo.
Criar sozinho um software para resolver uma necessidade pontual é uma coisa. Construir software que sustenta uma operação e será mantido e evoluído por um time é outra. Engenharia começa quando entra a variável tempo. As Leis de Lehman ajudam a explicar por quê: software inserido no mundo real precisa ser continuamente adaptado para permanecer útil, e sua complexidade tende a crescer quando não há trabalho deliberado para contê-la. O software muda porque o negócio, os usuários e o ambiente também mudam. É aí que a engenharia se revela: quando outra pessoa precisa alterar o código, um requisito muda, uma falha precisa ser contida ou o negócio exige uma resposta sem refazer tudo do zero.
É por isso que teste, arquitetura e pipeline mostram seu valor. Teste não é valioso apenas porque aumenta cobertura. Arquitetura não é boa porque segue um padrão. Um pipeline não é maduro porque possui muitas etapas. Essas práticas importam quando reduzem o custo e o risco da próxima mudança e antecipam o feedback sobre seus efeitos.
Dessa definição derivam quatro critérios para avaliar a liderança técnica.
Tornar a operação de engenharia legível
Entrega, atraso, retrabalho e risco não podem depender apenas da memória ou da capacidade narrativa de quem está mais perto. O líder precisa estabelecer uma linha de base, acompanhar variações e permitir que o time compartilhe a mesma leitura sobre fluxo, qualidade e pontos de atenção.
Conduzir por sinais, não por opinião
Sinais não eliminam julgamento. Eles disciplinam o ponto de partida. Um valor fora do padrão reduz o campo de busca, ajuda a formular hipóteses e orienta a conversa. O dado abre a investigação. O contexto continua decidindo.
Construir autonomia com segurança
Autonomia não é ausência de limites. Segurança não é centralização. Um time autônomo conhece a intenção, recebe feedback rápido e sabe dentro de quais guardrails pode decidir sem esperar pela presença do líder.
Fazer a próxima mudança custar menos
Resolver o incidente atual pode ser necessário, mas não basta. Uma intervenção de liderança precisa deixar alguma capacidade: um teste, uma política, uma fronteira melhor, um alerta, uma conversa recorrente, conhecimento distribuído ou uma decisão que não precise ser rediscutida do zero.
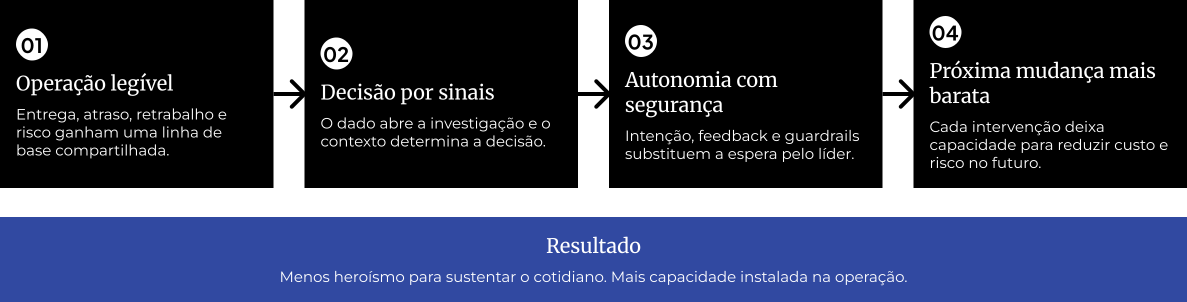
Essa régua muda o foco. O Tech Lead deixa de ser avaliado apenas pela velocidade com que resolve problemas e passa a ser avaliado pela qualidade das condições que cria para encontrá-los, tratá-los e evitar que permaneçam invisíveis.
Da régua à prática: como conduzir a operação de engenharia
Tornar a engenharia legível não significa observabilidade de aplicações, telemetria, logs ou traces. O objeto aqui é a operação de engenharia: o caminho entre a entrada de uma demanda e sua chegada à produção, as pessoas que sustentam esse caminho e o código que precisa continuar mudando.
Uma leitura útil deve responder a três perguntas:
- Onde a entrega se distancia do resultado esperado?
- Qual condição de trabalho produz essa distância?
- A intervenção melhorou a operação ou apenas deslocou o problema?
Para respondê-las, combinamos cinco dimensões da operação, três níveis de leitura e um ciclo de intervenção.
Cinco dimensões da operação de engenharia
As dimensões mostram onde procurar a origem de uma restrição.
Fluxo
Fluxo acompanha como o trabalho entra, atravessa filas e se transforma em valor. Aqui aparecem trabalho em progresso, tempo de atravessamento, tamanho de lote, variabilidade, bloqueios e retrabalho.
Código
Código acompanha onde mudança, conhecimento e risco se concentram. Aqui aparecem hotspots, ownership, acoplamento, instabilidade e volatilidade.
DevOps
DevOps acompanha como integração, teste, deploy e recuperação sustentam o ritmo. Uma fila na esteira, uma janela de release ou um feedback tardio pode explicar um atraso que a execução individual não explica.
Arquitetura
Arquitetura acompanha como fronteiras e dependências ampliam ou contêm o custo de uma alteração. A pergunta não é se o diagrama parece modular, mas se as partes conseguem mudar e chegar à produção com independência prática.
Governança
Governança acompanha como prioridades, políticas, aprovações e decisões criam ou removem espera. Muitas restrições atribuídas ao time nascem fora dele.
As dimensões não são departamentos. Um problema real atravessa várias delas. Um lote grande pode nascer de uma política de aprovação, aparecer como fila no fluxo, aumentar o risco no deploy e exigir mudanças coordenadas em componentes que deveriam ser independentes.
Três níveis de leitura e nove sinais concretos
Os níveis organizam a investigação do resultado para as condições que podem explicá-lo. Primeiro observamos a entrega: seu ritmo, tempo e estabilidade. Quando existe uma diferença relevante em relação ao resultado esperado, examinamos pessoas e código em busca de sinais que ajudem a formular hipóteses. Essa ordem evita atribuir prematuramente o problema a uma pessoa ou a um componente isolado.
Nível 1
Entrega: estamos produzindo valor com ritmo e estabilidade?
Três métricas formam uma primeira leitura equilibrada.
Vazão
Vazão mede quantas entregas de valor chegam à produção em um período. O mais útil não é comparar times diferentes, mas acompanhar a série do mesmo time com uma convenção estável de contagem. Observe pelo menos algumas semanas, verifique se o denominador mudou e diferencie software em produção de item apenas marcado como concluído no board. Vazão indica ritmo, não esforço.
Cycle Time P85
Cycle Time P85 responde quanto tempo 85% das entregas levam para atravessar o fluxo. O percentil evita que a média esconda a cauda de itens demorados. Para observá-lo, mantenha constante o ponto que inicia e encerra a contagem e abra as fases do fluxo quando o P85 piorar. O desenvolvimento pode estar rápido enquanto os itens esperam dias por revisão, homologação ou deploy.
Change Failure Rate
Change Failure Rate mostra a proporção de mudanças em produção que exigem intervenção, como rollback ou hotfix. Ele funciona como contrapeso à velocidade. Sua leitura exige uma definição estável de falha e cobertura confiável dos deploys. Um percentual baixo não significa qualidade se apenas os rollbacks formais são registrados.
Leia as três em conjunto. Vazão maior com P85 pior pode indicar fechamento em lote. P85 menor com mais falhas pode indicar velocidade comprada com instabilidade. Vazão e P85 melhores com falhas estáveis formam evidência mais forte de melhoria real.
Essa leitura se conecta às métricas de entrega do DORA, mas precisa respeitar a unidade e o contexto da operação analisada.
Nível 2
Pessoas: onde uma conversa pode estar acontecendo tarde demais?
Métricas por pessoa exigem um contrato mais restritivo. Elas servem para localizar exceções de saúde e bloqueio, nunca para produzir ranking de produtividade. Três sinais podem ajudar.
Frequência de contribuição
Frequência de contribuição acompanha a presença de commits ou PRs numa janela suficiente para reduzir ruído. Não compare pessoas entre si. Compare o comportamento recente com o papel, a história e o tipo de trabalho daquela pessoa. Um Tech Lead pode contribuir menos código porque está habilitando o time. Uma queda pode significar férias, trabalho de apoio ou bloqueio.
Evidência de entrega individual
Evidência de entrega individual observa itens concluídos, mas não trata zero como prova de problema. Uma pessoa pode revisar, apoiar, atuar em incidentes ou estar no primeiro item. A ausência só se torna um sinal mais forte quando existe trabalho aberto envelhecendo ou outra evidência de que a entrega ficou presa.
Aging e Cycle Time
Aging e Cycle Time dos itens sob responsabilidade mostram o passado e o presente. O P85 das entregas concluídas funciona como retrovisor. A idade dos itens abertos permite agir antes que eles entrem na cauda. O melhor uso é destacar o item que se aproxima do limite esperado e perguntar o que falta para ele avançar.
Exemplo: commits presentes, nenhuma entrega concluída e um item envelhecendo podem indicar bloqueio. Os mesmos commits, sem item próprio e com várias revisões em trabalho de colegas, podem indicar contribuição de apoio. O painel não deve escolher entre essas histórias. Deve garantir que a conversa aconteça.
Nível 3
Código: onde a mudança concentra custo, conhecimento e coordenação?
Três sinais ajudam a transformar o repositório em evidência para decisões.
Hotspots
Hotspots são arquivos, módulos ou áreas alterados com frequência numa janela móvel, como os últimos três meses. Ordene as mudanças por artefato e observe onde elas se concentram. Um hotspot não é ordem automática de refatoração. É um lugar onde proteção por testes, inspeção de complexidade e entendimento de criticidade tendem a oferecer mais retorno.
Ownership
Ownership observa como as contribuições se distribuem e se os principais conhecedores continuam ativos. Procure os dois extremos: concentração que cria bus factor baixo e fragmentação que deixa o componente sem owner reconhecível. Cruze participação, recência e criticidade. O objetivo é responsabilidade clara com capacidade de mudança distribuída.
Acoplamento de mudança
Acoplamento de mudança identifica arquivos, repositórios ou unidades de deploy que são alterados juntos repetidamente. Um evento isolado não basta. Observe recorrência e compare o mapa de co-mudanças com as dependências estáticas. Co-mudança frequente sem uma dependência explícita pode revelar regra de negócio dispersa ou uma fronteira que não contém a alteração.
O cruzamento prioriza melhor que qualquer sinal sozinho. Um hotspot com ownership fragmentado e forte acoplamento de mudança concentra frequência, descontinuidade de conhecimento e propagação. É um candidato muito mais forte à intervenção do que um arquivo apenas complexo e quase nunca alterado.
O artigo O que o código revela sobre o design aprofunda essa leitura, suas cautelas e a maneira como o histórico de mudanças complementa a estrutura atual do código.

Nenhum nível produz um veredito sozinho. A força aparece quando sinais diferentes convergem para o mesmo mecanismo.
Como cruzar as leituras sem transformar métricas em vereditos
As nove métricas não formam um score. Elas reconstroem a história da mudança sob três perspectivas: o que chegou, quem precisou sustentar o trabalho e onde o código ampliou a coordenação.
O ciclo começa com uma linha de base. Defina o resultado esperado, a janela, a população, a fonte e as limitações de captura. Sem uma convenção estável, uma mudança no board ou na composição do time pode parecer melhoria ou piora.
Em seguida, procure uma divergência relevante. Alguns exemplos:
- Vazão estável, P85 piorando e itens abertos envelhecendo: a operação pode estar concluindo lotes antigos enquanto uma nova fila cresce. Abra o tempo por fase antes de cobrar mais atividade.
- Uma pessoa com Cycle Time alto atuando no principal hotspot: a diferença pode nascer da criticidade e do acoplamento do componente. Cruze ownership e filas de revisão antes de interpretar o sinal como dificuldade individual.
- Change Failure Rate em alta, co-mudança e ownership concentrado: mudanças se propagam por fronteiras frágeis e dependem de poucas pessoas. A ação pode combinar testes, redução de lote, distribuição de conhecimento e revisão de fronteiras.
Depois, formule uma hipótese que possa ser refutada. Escolha a menor intervenção responsável e defina a medida de saída antes de agir. Se a fila está na revisão, limite o trabalho que chega ou reserve capacidade para revisão. Se o risco está num hotspot, proteja o comportamento e inclua deliberadamente uma segunda pessoa nas próximas mudanças.
Por fim, verifique o resultado e transforme o aprendizado em feedback. Uma conversa, uma política, um teste, um alerta ou um guardrail deve fazer o próximo problema aparecer mais cedo.
O método não é medir tudo. É escolher sinais suficientes para localizar uma restrição, intervir nela e comprovar se a operação ficou melhor.
Uma boa leitura pode produzir uma boa decisão e ainda desaparecer depois do diagnóstico. O desafio seguinte é preservar a linha de base, acompanhar a intervenção e transformar o aprendizado em uma capacidade recorrente da operação.
Como tornar a melhoria recorrente: Engenharia de Alta Performance e FTC
É esse problema que a Engenharia de Alta Performance organiza na eximia.co. Ela transforma diagnóstico em um ciclo recorrente de intervenção, verificação e instalação de capacidade.
O método não começa por uma ferramenta nem termina num dashboard. Ele começa por um resultado que precisa melhorar, constrói uma leitura confiável da operação, prioriza a condição que mais encarece a mudança e acompanha se a intervenção produziu o efeito esperado.
A proposta não é medir a engenharia por medir. É criar um ciclo no qual evidência orienta prioridade, prioridade orienta intervenção e resultado orienta o próximo aprendizado.
Um método para tornar a melhoria repetível
A Engenharia de Alta Performance conecta as cinco dimensões apresentadas neste artigo: fluxo, código, DevOps, arquitetura e governança. Elas não são frentes independentes nem uma lista de auditoria. Formam o campo no qual a causa de uma restrição precisa ser localizada.
Na prática, o método avança em ondas. Cada onda define resultado e escopo, estabelece uma linha de base, diagnostica a restrição prioritária, executa uma intervenção verificável e acompanha a evolução para instalar capacidade. A onda seguinte não recomeça do zero: parte da nova condição da operação e do aprendizado que a anterior deixou incorporado.
Esses cinco movimentos formam um ciclo, não um projeto com diagnóstico no começo e relatório no fim. A maturidade aparece quando a operação consegue repetir o aprendizado sem depender de uma mobilização extraordinária.

FTC: a instrumentação que dá continuidade ao método
O FTC, Follow the Code, é a ferramenta que sustenta essa forma de trabalhar. Sua premissa é que engenharia é código no tempo: entrevistas e percepções explicam intenção, enquanto o histórico de trabalho e de mudanças registra o que aconteceu de fato.
O FTC organiza evidências que ajudam a estabelecer a linha de base e acompanhar a evolução. Dados de fluxo mostram como uma mudança atravessa a operação. O histórico do repositório mostra onde alterações, conhecimento e coordenação se concentram. A leitura temporal permite comparar períodos e verificar se a intervenção alterou o comportamento que pretendíamos mudar.
Na aplicação do método, a ferramenta cumpre três funções principais:
- Dar consistência à evidência, preservando definições, janelas e histórico;
- Aproximar sinais que normalmente ficam separados, conectando resultado de entrega ao comportamento do trabalho e do código;
- Manter continuidade, permitindo que a próxima conversa parta da evolução observada, não da memória de quem estava na reunião anterior.
Isso não significa que todas as lentes já existam numa única tela ou que o FTC produza automaticamente um diagnóstico. Painéis podem ser formas úteis de visualização, mas não são o centro da proposta. O método determina a pergunta e a decisão. O FTC torna a evidência repetível, comparável e auditável.
Como começar com uma onda
Uma onda não precisa começar com um cockpit completo. Começa com uma restrição real e um experimento verificável.
Defina o resultado. Escolha o custo, risco ou atraso que precisa diminuir. “Melhorar a entrega” é amplo demais. “Reduzir o tempo em revisão sem aumentar falhas” produz uma conversa operacional.
Estabeleça a linha de base. Defina janela, população, fonte e medida. Registre também as limitações da captura.
Encontre a divergência. Procure sinais que fogem do padrão ou contradizem a narrativa. Prefira séries e distribuições a um número isolado.
Cruze níveis e contexto. A hipótese aparece na entrega, nas pessoas, no código ou numa combinação?
Escolha a menor intervenção responsável. Atue na restrição sem redesenhar tudo.
Defina a medida de saída. Antes de agir, combine o que fará a intervenção ser mantida, ajustada ou revertida.
Transforme o aprendizado em feedback. Incorpore o aprendizado ao modo de trabalhar para que a melhoria deixe de depender da memória do Tech Lead.
Imagine um time com muita atividade e pouca entrega concluída. A reação por percepção seria cobrar velocidade. O ciclo começa diferente. A linha de base mostra que mudanças entram continuamente, mas aguardam revisão e são entregues em lote. O contexto revela que a aprovação ocorre em uma janela comum. A menor intervenção responsável reduz o lote e reserva capacidade diária para revisão. A medida de saída acompanha tempo de atravessamento, frequência de entrega e falhas. Se o fluxo melhora sem comprar instabilidade, a nova política passa a orientar o trabalho.
O líder não resolveu cada item represado. Mudou a condição que os represava.
Da capacidade instalada à autonomia
Uma onda bem-sucedida não deixa apenas um indicador melhor. Deixa uma capacidade incorporada ao modo de trabalhar: um limite de trabalho em progresso, uma política de revisão, um teste, uma fronteira arquitetural ou uma rotina de feedback. O FTC preserva a evidência entre as ondas; o método converte essa evidência em intervenção; e o time passa a decidir com menos dependência da presença do líder.
É nesse ponto que o método se aproxima da ideia de Fly by Wire. O líder explicita intenção, parâmetros e limites. A operação devolve sinais e feedback perto da ação. O time decide dentro dos guardrails sem esperar que o líder execute manualmente cada correção.
O instrumento não pilota. Métricas, painéis e automações não escolhem o objetivo, não entendem todo o contexto e não assumem responsabilidade. Pessoas continuam interpretando sinais, negociando trade-offs e revisando limites. Um guardrail protege uma consequência relevante; burocracia apenas pede permissão. Se toda exceção continua subindo para o Tech Lead, a centralização apenas ganhou uma interface.
O papel do líder muda. Em vez de decidir tudo, ele melhora a qualidade dos sinais e dos limites que permitem ao time decidir. Quando intenção, sinais e limites deixam de existir apenas na cabeça do líder, a operação ganha condições para seguir sem sua presença constante. É aí que surge o teste definitivo.
O teste das férias
Há uma pergunta simples para avaliar se a liderança está construindo capacidade ou dependência: o que acontece quando o Tech Lead sai de férias?
Se a entrega para, talvez a organização tenha premiado disponibilidade pessoal e chamado isso de liderança. Se o time continua avançando, reconhece exceções, respeita limites e sabe quando pedir ajuda, existe uma operação capaz de seguir sem a presença constante do líder.
Naquela reunião, o Tech Lead não se tornou um bom líder porque aceitou um dashboard. Tornou-se um bom líder naquele instante porque transformou um sinal incômodo em responsabilidade sobre a forma de trabalho. Em vez de defender a aparência de controle, decidiu construir visibilidade.
Liderança técnica não deveria ser medida pela quantidade de problemas que o líder resolve. Deveria ser medida pela capacidade de construir uma operação em que os problemas custam menos para aparecer, entender e resolver.
O primeiro passo não é montar um cockpit inteiro. É escolher uma sensação que orienta uma decisão importante, trocá-la por um sinal, formular uma hipótese e conduzir uma intervenção que possa ser verificada. Depois, transformar o que foi aprendido em uma capacidade que continue funcionando quando você não estiver na sala.
O teste das férias em cinco perguntas
A meta não é retirar julgamento humano da engenharia. É dar ao julgamento uma operação mais legível. Também não é eliminar líderes indispensáveis em momentos extraordinários. É evitar que o cotidiano inteiro seja extraordinário.
Se você tirar três semanas de férias, a entrega desacelera ou para?
Você sabe se o time entrega em ritmo ou em lote, ou conhece apenas a média?
Você consegue estimar o que o time concluirá até a data em que o negócio cobrará o resultado?
Você consegue apontar o centro nervoso do código que mais ameaça a próxima mudança?
Sua última decisão técnica se apoiou em um sinal ou numa sensação?
- Goldratt Research Labs. Introduction to Theory of Constraints.
- Erlang, A. K. The Theory of Probabilities and Telephone Conversations. Nyt Tidsskrift for Matematik B, 20, 33–39, 1909.
- Little, J. D. C. A Proof for the Queuing Formula: L = λW. Operations Research, 9(3), 383–387, 1961.
- DORA. DORA’s software delivery performance metrics. dora.dev
- Westrum, R. A typology of organisational cultures. Quality & Safety in Health Care, 2004.
- Bird, C., Nagappan, N., Murphy, B., Gall, H. e Devanbu, P. Don’t Touch My Code! Examining the Effects of Ownership on Software Quality. ESEC/FSE, 2011.
- DORA. Accelerate State of DevOps Report 2024. dora.dev
- DORA. State of AI-assisted Software Development 2025. dora.dev
- Lehman, M. M. Programs, Life Cycles, and Laws of Software Evolution. Proceedings of the IEEE, 68(9), 1060–1076, 1980.
- Kohlrausch, G. S. O que o código revela sobre o design. Eximia Insights, 25 ago. 2026.
- Júnior, E. Follow the Code: o código não mente. Eximia Insights, 20 mar. 2026.
- NASA. Fly-by-Wire: From Apollo to the Airlines.
Assista ao autor comentando este artigo

Vamos entender o próximo passo juntos?
Fale com um especialista da eximia.co sobre arquitetura, engenharia e tecnologia.


