

Toda empresa que roda Kubernetes em escala tem a mesma conversa uma vez por trimestre. Alguém do financeiro pergunta por que a fatura de cloud subiu de novo. Alguém da engenharia responde que o time cresceu, que os workloads aumentaram, que tem mais gente usando. E ninguém consegue provar nada, porque a fatura fala de instâncias EC2 e o negócio fala de produtos.
Essa distância entre o que a nuvem cobra e o que a empresa consome é o problema central do FinOps em Kubernetes. Não é um problema de ferramenta. É um problema de modelo.
Os números públicos são desconfortáveis. A pesquisa de FinOps cloud native da CNCF mostrou que 49% das organizações viram o custo de nuvem subir depois de adotar Kubernetes, 28% ficaram no mesmo patamar e apenas 24% economizaram. Entre quem gastou mais, o principal motivo apontado foi overprovisioning, com 70% das respostas, seguido por recursos que ninguém desliga depois do uso, com 43%.
O relatório de 2026 da Cast AI, baseado em medição direta de dezenas de milhares de clusters de produção, é ainda mais direto: a utilização média de CPU caiu para 8% em 2025, contra 10% no ano anterior, e a de memória caiu de 23% para 20%.
Vale ler de novo. A eficiência está piorando, não melhorando, à medida que a adoção amadurece.
A eficiência está piorando, não melhorando, à medida que a adoção amadurece.
O gráfico que resume tudo
O gap entre a capacidade provisionada e o que os workloads efetivamente pedem subiu de 40% para 69% em um ano. Em memória, esse gap está em 79%. Ou seja: a empresa paga por infraestrutura que os próprios workloads nem chegam a solicitar.
Se você empilhar as três camadas (o que foi provisionado, o que foi solicitado via requests e o que foi realmente consumido), o desenho fica assim:
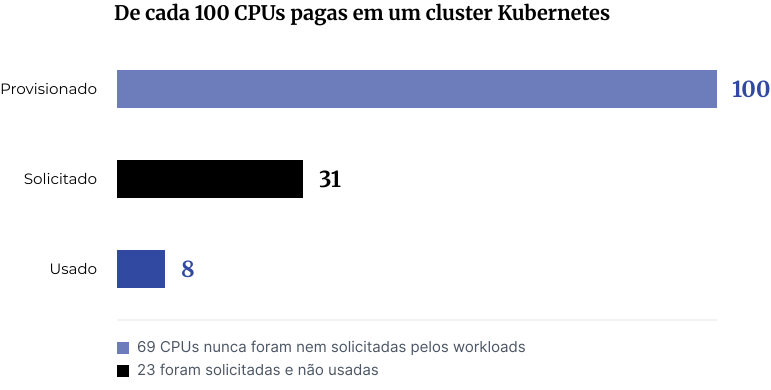
De cada 100 CPUs pagas em um cluster Kubernetes. Provisionado 100, solicitado 31, usado 8. Sessenta e nove CPUs nunca foram nem solicitadas; 23 foram solicitadas e não usadas. Insira o gráfico acima desta legenda. Fonte: Cast AI, 2026 State of Kubernetes Optimization Report.
Esse é o retrato médio. Se o seu cluster está melhor que isso, ótimo. Se você nunca mediu, a chance de estar pior é considerável.
Por que ratear custo em Kubernetes é genuinamente difícil
Fora de Kubernetes, a alocação de custo é razoavelmente mecânica: você marca o recurso com uma tag de centro de custo e pronto. Dentro de Kubernetes, aparece uma camada de indireção que quebra esse modelo. O time de produto não compra uma máquina, ele pede uma fração de máquina. E várias frações de vários times convivem no mesmo node, comprado por outra área.
Isso cria três buckets de custo que precisam de decisão explícita.
O custo direto de cada workload, que é a parte fácil. Modelos como OpenCost e Kubecost calculam isso multiplicando o preço por hora do node pela fração de CPU e memória que o pod reservou, hora a hora.
O custo idle, que é a capacidade do node que ninguém reivindicou. Se um node roda a 15% de utilização, 85% do custo daquele node precisa ir para algum lugar. Essa é a pergunta que trava a maioria dos programas de alocação.
O custo compartilhado, que é a plataforma: ingress controllers, service mesh, CoreDNS, daemonsets de log e métricas, cert-manager, operadores. Ninguém é dono e todo mundo usa.
Existem três respostas defensáveis para o idle, e a escolha muda o comportamento dos times:
| Modelo | Como funciona | Efeito prático |
|---|---|---|
| Distribuição proporcional | O idle é dividido entre times na proporção do que cada um solicitou | Cria incentivo direto para reduzir requests infladas |
| Bucket dedicado | O idle aparece como linha própria, sob o time de plataforma | Bom para começar: expõe o desperdício sem gerar briga |
| Rateio uniforme | Divide igualmente entre os times | Simples e injusto. Times pequenos subsidiam times grandes |
Uma escolha técnica aqui tem consequência política enorme, e é por isso que ela precisa ser feita antes do primeiro relatório sair, não depois.
O erro que parece justo e não é
A tentação natural é ratear por consumo real em vez de por requests. Parece mais justo: você paga pelo que usou. Na prática, isso cria um incentivo perverso. O time que quer reduzir o próprio custo passa a declarar requests menores, o scheduler empacota demais, e o resultado é throttling de CPU e latência em produção.
Para responsabilização interna, ratear por requests é o modelo correto. Se o time reservou, o time pagou, independentemente de ter usado. É exatamente esse desconforto que faz o rightsizing acontecer. Rateio por consumo real faz sentido em outro contexto: cálculo de COGS e margem por produto, onde o objetivo é entender economia unitária e não induzir comportamento.
Estratégia prática de alocação
Comece por namespace. É a fronteira mais barata de implementar e entrega a maior parte do valor. Um namespace por time ou por produto, com label obrigatória de centro de custo, resolve a maior parte do problema de atribuição.
Depois torne a label obrigatória de verdade, com admission control. Kyverno ou OPA Gatekeeper rejeitando deployment sem cost-center é mais eficaz que qualquer campanha interna de conscientização. Governança que depende de disciplina voluntária não sobrevive ao terceiro sprint.
Rode showback antes de chargeback, por pelo menos 90 dias. Segundo a pesquisa State of FinOps da FinOps Foundation, apenas 14% dos times chegam a implementar chargeback completo. Esse número não é um teto técnico, é um indicador de quanta confiança o modelo de alocação precisa acumular antes de mover orçamento de verdade. Publicar número errado uma vez custa meses de credibilidade.
E amarre cada relatório a uma meta nomeada. Showback sem dono e sem meta produz slides bonitos e nenhuma mudança de comportamento.
Nos assessments de FinOps que conduzimos na eximia.co, o gargalo raramente é a ferramenta. É a ausência de um acordo escrito sobre quem absorve o idle e quem paga a plataforma. Esse acordo é um artefato de arquitetura organizacional, não de engenharia.
O gargalo raramente é a ferramenta. É a ausência de um acordo escrito sobre quem absorve o idle.
Rightsizing de requests e limits
Aqui mora o dinheiro grande, e também o mal-entendido mais comum entre gestão e engenharia.
requests é o que o scheduler usa para decidir onde o pod cabe, e é o que o cluster autoscaler usa para decidir se precisa de mais node. limits é o teto de execução. Para memória, estourar o limit significa OOMKill. Para CPU, significa throttling via CFS quota, que não mata o processo mas degrada latência de um jeito difícil de diagnosticar.
O ciclo vicioso funciona assim. Um engenheiro define requests com folga generosa para não ter dor de cabeça. Essa configuração nunca mais é revisada, porque não existe processo para revisá-la. O valor é propagado via Helm chart para todos os ambientes, inclusive os que têm um décimo da carga. E o autoscaler, que responde a requests e não a uso real, provisiona nodes para atender uma demanda que é ficção.
O relatório de Kubernetes empresarial da Komodor, com dados operacionais de centenas de clientes, encontrou mais de 65% dos workloads rodando abaixo da metade do CPU ou memória que solicitaram. Não é um caso extremo. É a mediana do mercado.
A parte contraintuitiva
A crença de que folga generosa protege a confiabilidade não sobrevive aos dados. O relatório da Cast AI documenta um cluster representativo com média de 40 a 50 OOM kills por intervalo de medição, apesar de padding generoso. Após rightsizing automatizado, que também cortou pela metade as CPUs provisionadas, os OOM kills caíram para perto de zero.
O motivo é simples e vale explicar para a gestão: overprovisioning estático é um instrumento cego. Ele adiciona capacidade uniformemente, inclusive onde não precisa, e deixa intocados justamente os workloads cuja pegada de memória cresceu desde o último deploy. Ajuste contínuo funciona nas duas direções.
Como fazer na prática
Meça percentis, não médias. Uma boa regra de partida é requests de CPU no p95 de 14 dias com margem, e requests de memória no p99, porque memória é recurso não compressível e errar para baixo mata o pod.
Sobre limits de CPU, há uma discussão honesta na comunidade. Definir limit de CPU garante previsibilidade de vizinhança mas introduz throttling mesmo quando o node tem CPU sobrando. Em muitos ambientes com requests bem calibradas e quotas por namespace, remover limits de CPU melhora latência sem custo adicional. Já limits de memória devem existir sempre.
Use VPA em modo recomendação, não em modo automático de cara. A recomendação vira pull request no repositório de manifestos, com revisão humana, e assim o valor correto fica versionado onde deveria estar. Configuração que só existe em runtime volta ao valor errado no próximo deploy.
E cuidado com o conflito clássico: HPA escalando réplicas por CPU e VPA ajustando requests de CPU ao mesmo tempo brigam entre si. Escolha um eixo por workload.
Um detalhe que quase todo mundo esquece: se as requests estão infladas, o HPA praticamente nunca dispara, porque ele calcula utilização como percentual da request. Um pod que pede 2 CPUs e usa 0,2 está a 10% de utilização e nunca vai escalar, mesmo saturado em relação à sua carga real. Rightsizing e autoscaling são o mesmo problema, não dois.
O custo silencioso dos clusters ociosos
Kubernetes cobra por existir, não só por usar.
No Amazon EKS, cada cluster custa 0,10 dólar por hora enquanto a versão do Kubernetes está em suporte padrão, e 0,60 dólar por hora quando entra em suporte estendido. São 73 dólares por mês contra 438 dólares por mês. Pelo mesmo control plane. A única diferença é o número da versão.
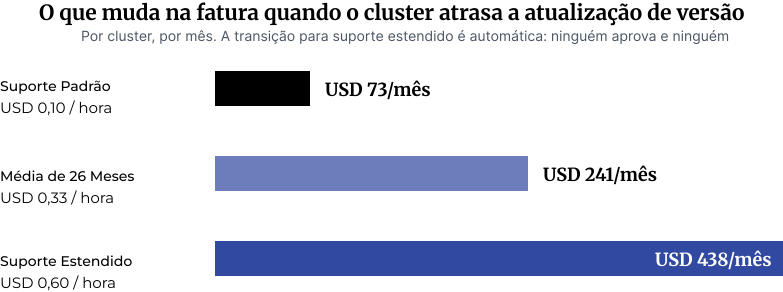
O que muda na fatura quando o cluster atrasa a atualização de versão. Suporte padrão USD 73/mês; média de 26 meses USD 241/mês; suporte estendido USD 438/mês. A transição para suporte estendido é automática. Insira o gráfico acima desta legenda. Fonte: AWS, documentação de preços do Amazon EKS.
Multiplique por cluster sprawl. Três ambientes por produto, cinco produtos, mais os clusters de prova de conceito que nunca foram destruídos: são 20 control planes, 1.460 dólares por mês antes de qualquer pod subir. Se metade estiver em suporte estendido, o número passa de 5.000.
Já encontrei cluster de prova de conceito rodando havia 14 meses porque a pessoa que criou tinha saído da empresa e ninguém sabia se derrubar quebrava alguma coisa. Custava mais que o ambiente de homologação do produto principal. Esse tipo de achado é constrangedor de apresentar e é dos mais fáceis de resolver.
E há a aritmética do tempo. Um ambiente de desenvolvimento usado 40 horas por semana e ligado 168 fica 76% do tempo ocioso. Você paga o node, o control plane, o volume EBS anexado, o Load Balancer, o NAT Gateway processando dados de imagens que ninguém está puxando.
Estratégias que funcionam, em ordem de retorno sobre esforço:
Desligue ambientes não produtivos fora do horário comercial. Ferramentas como kube-green fazem isso por anotação de namespace, sem tocar nos manifestos. Retorno típico entre 60% e 70% do custo de não produção, com risco operacional próximo de zero.
Consolide não produção em menos clusters, usando namespace e ResourceQuota como isolamento em vez de cluster dedicado. Isolamento por cluster é uma decisão de segurança legítima em alguns casos, mas frequentemente é só inércia organizacional cobrando 73 dólares por mês.
Adote clusters efêmeros com TTL para ambientes de pull request, destruídos automaticamente no merge.
Trate atualização de versão como item de custo, não só de segurança. Uma política de manter todos os clusters em suporte padrão se paga sozinha.
Varra recursos órfãos com regularidade: Load Balancers sem service, volumes EBS desanexados, snapshots antigos, Elastic IPs sem associação. É trabalho chato e é dinheiro parado.
Spot instances: a maior economia que ninguém captura
Os números são grandes o bastante para chamar atenção da diretoria. Clusters que usam parcialmente spot instances reduzem o custo médio de computação em 59%. Clusters que rodam exclusivamente em spot chegam a 77%.
A objeção é sempre a mesma: interrupção. E ela é legítima, mas menos absoluta do que parece. O dado que mudou a minha cabeça sobre isso é a variância entre regiões.
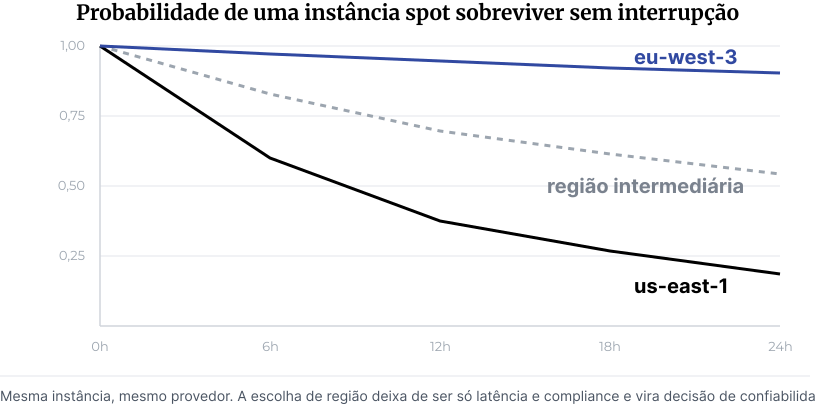
Probabilidade de uma instância spot sobreviver sem interrupção. Curvas de sobrevivência em 24 horas: eu-west-3 permanece acima de 0,9; us-east-1 cai abaixo de 0,2. Mesma instância, mesmo provedor. Insira o gráfico acima desta legenda. Fonte: Cast AI, 2026 State of Kubernetes Optimization Report (NVIDIA T4 em g4dn.xlarge).
A região eu-west-3 mantém probabilidade de sobrevivência acima de 0,9 durante as 24 horas inteiras. Já eu-central-1 e us-east-1 caem abaixo de 0,2 na mesma janela, o que significa cerca de 80% de chance de interrupção em um dia. Mesma instância, mesmo provedor, comportamento completamente diferente.
Além disso, o preço de spot varia de 2 a 5 vezes entre regiões dos Estados Unidos, e um time disposto a mover workloads conforme as condições de mercado poderia reduzir o custo de computação entre 50% e 80%.
Como estruturar isso sem quebrar produção
Classifique os workloads por tolerância a interrupção antes de qualquer coisa. APIs stateless atrás de load balancer, jobs de processamento em lote, runners de CI, consumidores de fila com idempotência e todos os ambientes de não produção são candidatos naturais. Bancos com replicação síncrona, singletons stateful e treinamentos longos sem checkpoint não são.
Defina uma política de proporção spot por camada de criticidade. Produção crítica com 50% spot e 50% on demand, produção não crítica com 80%, não produção com 100%. Isso é uma decisão de gestão de risco e cabe em uma página.
No plano técnico, o que faz diferença é diversificação. Muitos tipos de instância elegíveis, múltiplas zonas de disponibilidade e estratégia de alocação capacity-optimized-prioritized reduzem drasticamente a probabilidade de perder capacidade toda de uma vez. Karpenter lida com o aviso de interrupção nativamente, drenando o node antes do desligamento. PodDisruptionBudgets garantem que a drenagem não derrube o serviço junto.
Um ponto que vale registrar para quem está construindo plataforma de IA: menos de 2% das GPUs rodavam em spot ao longo de 2025. Com utilização média de GPU em 5% e preços de GPU subindo em vez de cair, essa é provavelmente a maior bolsa de desperdício não capturada do mercado hoje. Confesso que aqui eu tenho mais simpatia pela relutância dos times: perder um treinamento de oito horas na sexta à noite é um tipo específico de sofrimento. Mas 5% de utilização em hardware que custa dólares por hora não fecha em nenhuma planilha, e checkpoint é problema resolvido há décadas.
FinOps aplicado a autoscaling
Autoscaling é vendido como recurso de eficiência. Na prática, mal configurado, ele é uma máquina de amplificar erro de dimensionamento.
Vale separar os quatro mecanismos, porque eles resolvem problemas diferentes e as pessoas os confundem em reunião.
O HPA ajusta o número de réplicas com base em utilização relativa às requests. Só funciona se as requests forem honestas.
O VPA ajusta as requests de cada pod com base no consumo histórico. Resolve o problema de dimensionamento, não o de carga.
O KEDA escala com base em sinais externos, como profundidade de fila ou lag de consumidor, e sabe escalar até zero. Para arquiteturas orientadas a eventos, é o mecanismo mais alinhado ao custo real.
Karpenter e o Cluster Autoscaler decidem sobre nodes. E aqui está a armadilha: tanto o Cluster Autoscaler nativo quanto o Karpenter provisionam nodes com base em recursos solicitados, não em uso real. Quando os workloads pedem demais, o autoscaler trata isso como demanda legítima e adiciona nodes, aprofundando o gap.
Traduzindo para a gestão: o autoscaler está fazendo o trabalho dele corretamente. O problema é que a informação que ele recebe está errada.
Do lado das estratégias que rendem, três pontos merecem atenção.
Consolidação, que é o Karpenter reavaliando continuamente se os pods atuais caberiam em menos nodes ou em nodes mais baratos, é onde mora a maior parte do ganho de bin packing. Vale configurar com WhenEmptyOrUnderutilized e um consolidateAfter compatível com a tolerância a churn do ambiente.
Headroom deliberado, via pods de baixa prioridade que existem só para reservar capacidade e serem despejados quando a carga real chega, é uma troca explícita de dinheiro por latência de escalonamento. Não tem nada de errado nisso, desde que o custo esteja quantificado. A pergunta certa para a diretoria não é quanto custa esse headroom, é quanto custa não ter. Se a resposta for desconhecida dos dois lados, a discussão é ideológica.
Arquitetura ARM merece uma revisão de decisão. Nodes ARM cresceram 3,5 vezes mais rápido que x86 desde o segundo trimestre de 2024 e já representam 9% da frota total de CPUs. Para serviços stateless típicos de Kubernetes, o ganho de preço por performance do Graviton compõe com rightsizing e spot: são três eixos de economia sobre a mesma carga.
E a métrica que deveria estar no painel executivo não é custo por node. É custo por mil requisições, custo por transação processada, custo por usuário ativo. Um cluster que dobra de custo porque a receita triplicou é um cluster saudável. O número absoluto não conta essa história.
Observabilidade: o instrumento que às vezes custa mais que o problema
Existe uma ironia estrutural em Kubernetes. Você precisa de observabilidade para encontrar desperdício, e a observabilidade em si é uma das maiores linhas de custo escondidas.
A pesquisa de observabilidade da Grafana Labs de 2025 encontrou gasto médio de 17% do total de infraestrutura de computação, com 10% como resposta mais frequente. Em ambientes intensivos em Kubernetes, o percentual costuma ser maior, porque a natureza efêmera dos pods multiplica cardinalidade.
O caso público mais citado continua sendo o da Coinbase. A conta de 65 milhões de dólares referente a 2021 foi quitada no primeiro trimestre de 2022, e a empresa chegou a construir uma alternativa interna com Prometheus e Grafana antes de renegociar. A conta da análise era brutal: dez engenheiros sêniores na Bay Area custariam menos de 5 milhões por ano. Poucas empresas chegam a esse patamar, mas o padrão de crescimento superlinear é o mesmo em qualquer escala.
Três mecanismos explicam por que a conta de observabilidade cresce mais rápido que a infraestrutura que ela monitora.
Cardinalidade é o principal. Cada combinação única de labels vira uma série temporal cobrada. Em Kubernetes, pod, namespace, container, deployment e version se multiplicam combinatoriamente, e cada deploy cria um conjunto novo de séries. É por isso que a conta cresce mesmo com a infraestrutura estável.
Modelo de cobrança por host acoplado a autoscaling cria um efeito que quase ninguém modela. Plataformas que faturam pelo percentil 99 da contagem de hosts do mês cobram o mês inteiro pelo pico. Se o seu cluster escala de 100 para 300 nodes durante quatro horas na Black Friday, o mês todo é faturado sobre 300. A economia que o autoscaling gerou no compute pode ser parcialmente devolvida na observabilidade, e essa conta raramente aparece no mesmo relatório.
Logs concentram a maior parte do gasto e são a categoria mais redundante. Um health check de rotina custa o mesmo que um erro crítico de produção.
Estratégias de observabilidade
Estabeleça orçamento de cardinalidade por time, com número explícito de séries ativas. Sem teto declarado, cardinalidade cresce até a fatura reagir.
Filtre na origem, não no destino. O OpenTelemetry Collector e o metric_relabel_configs do Prometheus permitem descartar labels de alta cardinalidade antes da ingestão. Descartar pod_name e container_id de métricas agregadas costuma cortar uma fração significativa da conta sem perda operacional relevante.
Adote tail based sampling para traces, mantendo 100% das requisições com erro ou latência alta e amostrando o resto.
Separe camadas de retenção. Métricas quentes por 15 dias em armazenamento caro, dados frios em object storage com consulta sob demanda. Grande parte dos logs indexados nunca é consultada, e você está pagando índice para dados que ninguém lê.
Trate observabilidade como linha rateada para os times que a geram, não como custo central absorvido pela plataforma. O comportamento muda quando o custo aparece no relatório de quem instrumentou.
O preço da complexidade operacional
Esta é a parte que não aparece na fatura de nuvem e que, em empresas médias, costuma ser a maior linha de todas.
O relatório da Komodor aponta que times de plataforma perdem 34 dias úteis por ano resolvendo problemas, e que quase 8 em cada 10 incidentes de produção decorrem de mudanças recentes no sistema.
Vamos colocar em números que fazem sentido para a diretoria brasileira. Uma squad de plataforma com três pessoas experientes custa, em custo total para a empresa, algo na ordem de um milhão de reais por ano. Um cluster EKS de porte médio, digamos oito mil dólares por mês, custa cerca de meio milhão de reais por ano.
Ou seja: em uma quantidade enorme de empresas brasileiras, o time que opera a plataforma custa o dobro da plataforma.
Isso muda completamente a natureza da conversa. Discutir se vale a pena cortar 15% do compute enquanto se ignora que a operação consome dois terços do TCO é otimizar o denominador errado. E há um agravante recorrente: o ciclo de atualização. Kubernetes lança versão menor a cada poucos meses, o EKS oferece 14 meses de suporte padrão por versão, e cada atualização mobiliza pessoas, planejamento e janela de risco. É um custo recorrente que ninguém orça e todo mundo paga.
O que ajuda de fato:
Padronizar. Cinco clusters configurados de cinco jeitos diferentes custam mais que vinte clusters idênticos. Terraform com módulos versionados e uma única fonte de verdade para configuração de node group elimina uma classe inteira de trabalho manual.
Automatizar o ciclo de vida dos nodes, incluindo atualização de AMI, com respeito a disruption budgets.
Reduzir superfície. Cada operador, cada service mesh, cada CRD instalada é uma dívida operacional perpétua. A pergunta antes de instalar deveria ser quantas horas por ano isso vai consumir, não se resolve o problema de hoje.
Quando Kubernetes deixa de ser economicamente justificável
Esta seção costuma incomodar, e é a mais importante do artigo.
Kubernetes entrega valor econômico quando você usa três coisas: elasticidade real, densidade de empacotamento e padronização de operação em escala. Se a sua carga é previsível, se você tem poucos serviços e se não existe time de plataforma, você está pagando a complexidade sem consumir o benefício.
Dois casos públicos ancoram bem essa discussão.
O time de Video Quality Analysis da Prime Video reescreveu um sistema distribuído orquestrado por Step Functions como um processo único. O resultado foi redução de mais de 90% no custo de infraestrutura, além de aumento na capacidade de escala. A conclusão do próprio time foi que microsserviços e componentes serverless funcionam em larga escala, mas a decisão de usá-los em vez de um monolito precisa ser caso a caso.
A 37signals fez o caminho da repatriação. Depois de gastar 700 mil dólares em servidores Dell para trazer de volta cargas que rodavam na AWS, a conta de nuvem caiu cerca de 2 milhões de dólares por ano. A projeção é que a fatura anual de infraestrutura saia de 3,2 milhões de dólares para bem abaixo de um milhão, sem contratar pessoal adicional. A frase do DHH que resume a tese é dura e tem fundo: qualquer SaaS de porte médio com carga estável que não compara o aluguel de servidores na nuvem com a compra dos próprios está cometendo negligência financeira.
Nenhum desses casos é argumento contra Kubernetes. São argumentos contra usar Kubernetes por inércia.
Critérios objetivos para reavaliar
| Sinal | O que sugere |
|---|---|
| Menos de 10 serviços independentes e menos de 15 pessoas em desenvolvimento | ECS Fargate, Cloud Run ou App Runner provavelmente entregam o mesmo com uma fração do custo operacional |
| Carga com variação menor que 3x entre pico e vale | A elasticidade que você paga não está sendo usada. Bin packing rende pouco |
| Cluster com tamanho fixo 24 horas por dia | Você está usando Kubernetes como gerenciador de configuração caro |
| Ausência de time dedicado de plataforma | O custo operacional está escondido no tempo dos times de produto, e é maior do que parece |
| Custo de pessoas de plataforma maior que 50% do TCO da plataforma | Simplificação da arquitetura tem retorno maior que qualquer otimização de compute |
O inverso também vale. Se você tem dezenas de times autônomos, requisitos de multi-tenancy, presença multirregião e um catálogo grande de serviços, Kubernetes é provavelmente a opção mais barata disponível. A questão nunca foi a tecnologia. Foi o encaixe entre a complexidade da ferramenta e a complexidade do problema.
O que causa o desperdício e o roteiro de 90 dias
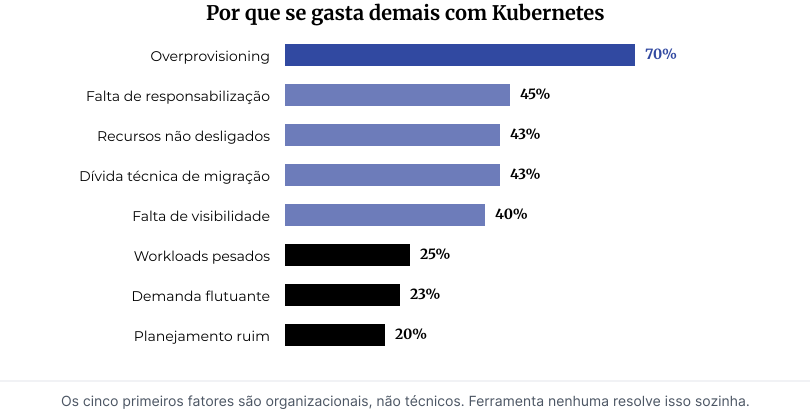
Por que se gasta demais com Kubernetes. Overprovisioning 70%, falta de responsabilização 45%, recursos não desligados 43%, dívida técnica de migração 43%, falta de visibilidade 40%, workloads pesados 25%, demanda flutuante 23%, planejamento ruim 20%. Os cinco primeiros fatores são organizacionais. Insira o gráfico acima desta legenda. Fonte: CNCF, Cloud Native and Kubernetes FinOps Microsurvey.
Repare na natureza dos fatores. Overprovisioning, falta de responsabilização, recursos esquecidos e falta de visibilidade não são limitações do Kubernetes. São sintomas de ausência de modelo de custo. É por isso que comprar uma ferramenta de FinOps e não mudar o processo produz painel bonito e fatura idêntica.
01 a 30: visibilidade
Instale OpenCost ou Kubecost, defina a taxonomia de labels obrigatórias, ligue admission control para rejeitar recursos sem centro de custo, e feche o acordo escrito sobre rateio de idle e de custo compartilhado. Publique o primeiro relatório de showback por namespace, mesmo imperfeito, e diga que é imperfeito.
31 a 60: ganhos rápidos
Desligue não produção fora do horário, corrija as dez maiores discrepâncias entre requests e uso real, migre não produção inteira para spot, verifique se algum cluster caiu em suporte estendido, limpe recursos órfãos. Essa fase costuma pagar o projeto inteiro.
61 a 90: estrutura
Configure consolidação no Karpenter, revise a política de autoscaling por workload, estabeleça orçamento de cardinalidade de observabilidade, avalie cobertura de commitment frente à nova baseline de consumo (depois do rightsizing, nunca antes, ou você compromete capacidade que vai deixar de usar), e publique as primeiras métricas de economia unitária.
O indicador de que deu certo não é o valor absoluto da fatura. É a existência de um número de custo por unidade de negócio que a engenharia e o financeiro olham juntos e concordam que está correto.
FinOps em Kubernetes é uma daquelas disciplinas em que o conhecimento técnico isolado não resolve. Você precisa de alguém que entenda de requests e de CFS quota, e que também consiga sentar com a diretoria financeira e explicar por que o rateio proporcional de idle é a escolha certa mesmo sendo a mais desconfortável. Nos assessments de FinOps para ambientes Kubernetes, o roteiro é o descrito acima: modelo de alocação primeiro, ganhos rápidos depois, estrutura de governança por último. Sem isso, otimização vira evento isolado e o custo volta ao patamar anterior em dois trimestres.
Antes de fechar esta página
Você conhece a utilização média de CPU e o gap entre o provisionado e o solicitado no seu cluster — ou só a fatura total?
Existe acordo escrito sobre quem absorve o idle e quem paga a plataforma, ou isso só aparece na briga depois do relatório?
Não produção desliga fora do horário, spot está em uso onde cabe, e algum cluster já caiu em suporte estendido sem ninguém notar?
O custo de pessoas de plataforma é maior que metade do TCO da plataforma — e, se for, a conversa ainda é só sobre cortar compute?
- CNCF. Cloud Native and Kubernetes FinOps Microsurvey.
- Cast AI. 2026 State of Kubernetes Optimization Report e 2025 Kubernetes Cost Benchmark Report.
- Komodor. 2025 Enterprise Kubernetes Report.
- Grafana Labs. Observability Survey 2025.
- FinOps Foundation. State of FinOps.
- AWS. Documentação de preços do Amazon EKS e do suporte estendido. aws.amazon.com
- Prime Video Tech Blog. Rearquitetura do serviço de monitoramento de áudio e vídeo.
- The Pragmatic Engineer e The Register. Cobertura dos casos Coinbase e 37signals.

Vamos entender o próximo passo juntos?
Fale com um especialista da eximia.co sobre arquitetura, engenharia e tecnologia.