Em 3 de junho de 2026, a Linux Foundation anunciou a intenção de criar a Tokenomics Foundation, em parceria com a FinOps Foundation, para estabelecer padrões abertos de medição de custo em IA. Entre as organizações que declararam apoio inicial estão Accenture, Booking.com, Google Cloud, IBM, JPMorganChase, KPMG, Microsoft, Oracle, Salesforce, SAP e ServiceNow.
Quando esse conjunto de empresas se move na mesma direção ao mesmo tempo, normalmente é porque alguma coisa saiu do controle. E saiu.
O que saiu do controle é a conta de IA. Não porque os preços subiram. Os preços caíram, e caíram muito. O custo de inferência para uma capacidade equivalente vem caindo cerca de 10 vezes por ano desde 2021, segundo a Andreessen Horowitz. Mesmo assim, o gasto corporativo com IA generativa saltou de 1,7 bilhão de dólares em 2023 para 37 bilhões em 2025, segundo a Menlo Ventures. Esse é o paradoxo que este guia se propõe a explicar, e é a razão pela qual “esperar o preço cair” não é uma estratégia.
Tokenomics é a disciplina que trata o token como unidade contábil da IA, do mesmo jeito que FinOps trata a hora de máquina como unidade contábil da nuvem. Ela responde a três perguntas que hoje quase nenhuma organização consegue responder com números: quanto custa cada funcionalidade de IA em produção, quem consumiu esse custo, e se o valor gerado justifica a conta.
Esperar o preço cair não é uma estratégia.
O que é Tokenomics, e o que não é
Comecemos eliminando uma confusão que atrapalha muita reunião. O termo nasceu no mundo de criptoativos, onde descreve o desenho econômico de um token digital: emissão, distribuição, incentivos, governança. Nesse contexto, o token é um ativo com preço de mercado. Não é disso que este guia trata.
Em IA, um token não representa propriedade. Ele representa computação. É o fragmento mínimo de texto, imagem, áudio ou vídeo que um modelo processa, e é a unidade pela qual o provedor cobra. A FinOps Foundation define a prática como a extensão da disciplina de custo variável para uma camada onde o recurso consumido é probabilístico, não determinístico, e precificado por ato inferencial.
Traduzindo para linguagem de gestão: você contratou um fornecedor que cobra por unidade de raciocínio, e o volume de unidades consumidas depende de decisões de engenharia que ninguém no financeiro consegue auditar. Esse é o problema.
A analogia com FinOps ajuda, mas tem limite. Na nuvem tradicional, o custo é razoavelmente previsível a partir da configuração. Em IA, duas execuções idênticas da mesma tarefa podem custar valores muito diferentes, porque o modelo decide quanto pensar. J.R. Storment, diretor executivo da FinOps Foundation, resumiu a diferença ao dizer que os direcionadores de custo agora incluem arquitetura de modelo, eficiência de inferência e escolha de geração de hardware, coisas que estão bem abaixo da camada onde FinOps tradicionalmente opera.
Como funciona: a mecânica do token
O que é um token, de verdade
Um modelo de linguagem nunca lê letras nem palavras. Ele lê números inteiros, cada um representando um fragmento de texto previamente catalogado no vocabulário do modelo. O software que faz essa conversão é o tokenizer, e ele é treinado antes do modelo. O algoritmo mais comum é o Byte Pair Encoding, inventado por Philip Gage em 1994 como técnica de compressão de dados.
A regra prática mais difundida é que um token equivale a cerca de 4 caracteres, ou 0,75 palavra em inglês. Mil tokens são aproximadamente 750 palavras. Guarde a expressão “em inglês”. Ela custa dinheiro.
O imposto do português
Como o tokenizer é treinado majoritariamente sobre texto em inglês, os padrões do inglês recebem codificação eficiente e os demais idiomas ficam fragmentados. Um estudo publicado no arXiv sobre injustiça de tokenização entre idiomas mediu que o português, apesar de ser dos idiomas mais próximos da paridade com o inglês nos tokenizers da OpenAI, ainda exige cerca de 50% mais tokens para o mesmo conteúdo. Testes com o tokenizer cl100k_base mostram o português consumindo aproximadamente 1,46 vez os tokens do texto equivalente em inglês.
Para uma empresa brasileira, isso significa que toda estimativa de custo baseada em benchmark em inglês está subdimensionada em algo entre 30% e 50%. É um erro silencioso e recorrente. Os tokenizers mais recentes, como o o200k_base, comprimem texto não inglês entre 20% e 50% melhor. A diferença diminuiu, mas não desapareceu. A recomendação operacional é simples: meça com o tokenizer do modelo que você vai usar, sobre texto real da sua operação, antes de precificar qualquer coisa.
Entrada e saída não custam a mesma coisa
Tokens de entrada são lidos em uma única passagem paralela. Tokens de saída são gerados um a um, em sequência, cada um exigindo uma passagem completa pelo modelo. Por isso a saída custa tipicamente de 3 a 6 vezes mais que a entrada, e em modelos de raciocínio premium a diferença chega a ser maior.
A consequência prática é que a forma da tarefa importa mais que o volume bruto de dados. Classificar dez mil documentos, produzindo uma palavra de saída para cada, é barato. Resumir os mesmos dez mil documentos em três parágrafos cada é caro. Modelos de orçamento que tratam entrada e saída como a mesma coisa erram por um fator de vários múltiplos, e erram sempre para baixo.
O contexto é recobrado a cada rodada
Modelos não têm memória entre chamadas. Em uma conversa de múltiplas rodadas, cada nova chamada envia de volta todo o histórico anterior. Na décima rodada, você está pagando pela primeira mensagem pela décima vez.
Para uma saída de tamanho idêntico, o custo por chamada na décima rodada chega a ser cerca de 7 vezes o custo da primeira, e o custo acumulado da conversa cresce muito mais rápido que o número de rodadas.
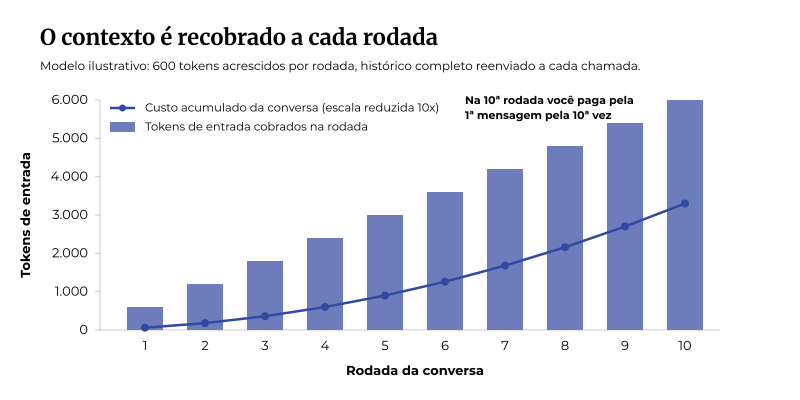
Isso explica por que um assistente conversacional de suporte pode ficar caro mesmo com preço por token baixo, e por que política de truncamento de histórico é decisão de arquitetura, não detalhe de implementação.
Tokens de raciocínio: o custo que você paga e não vê
Modelos de raciocínio geram tokens internos de “pensamento” antes de produzir a resposta. Você paga por eles, mas eles não aparecem na saída. Uma requisição complexa pode gerar dez mil tokens de raciocínio ou mais.
Um estudo publicado no arXiv em 2026 mediu a composição de saída em cargas agênticas e encontrou variantes de raciocínio gastando entre 45,8% e 67,6% dos tokens de saída em pensamento, enquanto variantes sem raciocínio geram zero. Uma tarefa que custa 1 dólar em um modelo padrão pode custar de 5 a 20 dólares em um modelo de raciocínio.
Usar modelo de raciocínio para tarefa simples é uma das causas mais comuns de estouro de orçamento. E é uma decisão que quase sempre é tomada por padrão, não por análise.
Agentes mudam a escala do problema
Um estudo sistemático de consumo de tokens em tarefas agênticas de programação, analisando trajetórias de oito modelos de fronteira no SWE-bench Verified, encontrou que tarefas agênticas consomem cerca de mil vezes mais tokens que raciocínio sobre código ou conversa sobre código, com os tokens de entrada, e não os de saída, dominando o custo. O mesmo estudo encontrou algo mais desconfortável para quem precisa orçar: execuções da mesma tarefa podem diferir em até 30 vezes no total de tokens, e consumo maior não se traduz em resultado melhor.
Trinta vezes de variância na mesma tarefa. Não é estimativa ruim: é propriedade do sistema.
No volume agregado, o efeito já aparece. O volume semanal de tokens processados na plataforma OpenRouter saiu de 0,4 trilhão em dezembro de 2024 para 27,0 trilhões em março de 2026, quase 68 vezes em quinze meses. Trabalho acadêmico sobre o tema mostra que o componente agêntico do tráfego, medido pelas requisições que terminam em chamada de ferramenta, cresce mais rápido que o não agêntico.
O preço cai, a conta sobe
A a16z batizou de LLMflation a queda no custo de inferência: para um modelo de capacidade equivalente, o custo cai cerca de 10 vezes por ano. Um modelo com desempenho de GPT-3 custava 60 dólares por milhão de tokens em novembro de 2021 e passou a custar 0,06 dólar por milhão três anos depois. A Epoch AI, que acompanha isso com mais granularidade, encontrou variação enorme conforme a tarefa, de 9 a 900 vezes ao ano, com mediana em torno de 50 vezes.
E ainda assim as contas sobem.
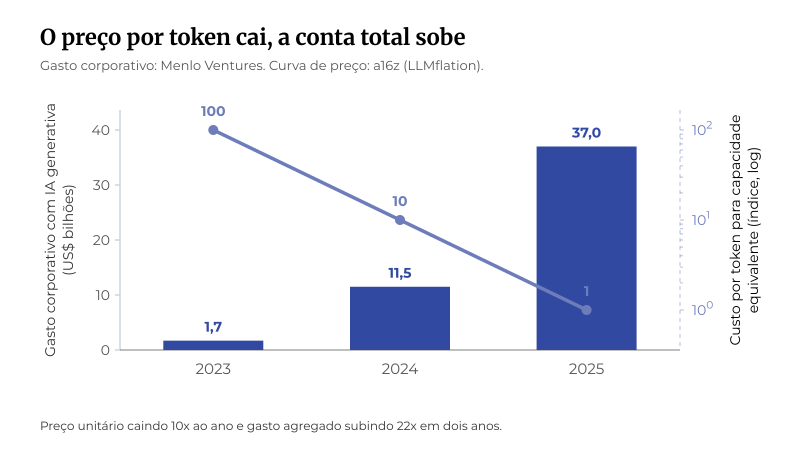
O gasto corporativo com IA generativa foi de 1,7 bilhão de dólares em 2023, 11,5 bilhões em 2024 e 37 bilhões em 2025, segundo pesquisa da Menlo Ventures com cerca de 500 decisores de compra nos Estados Unidos. Um crescimento de 3,2 vezes em um ano, e de mais de 20 vezes em dois. A categoria capturou 6% do mercado global de software em três anos, o crescimento mais rápido já registrado em software corporativo.
O motivo é o Paradoxo de Jevons, o mesmo fenômeno que fez o carvão mais eficiente aumentar o consumo de carvão na Inglaterra do século XIX. Quando o preço unitário cai, casos de uso antes inviáveis passam a fazer sentido, o volume explode, e o produto de preço menor por volume muito maior é uma conta maior.
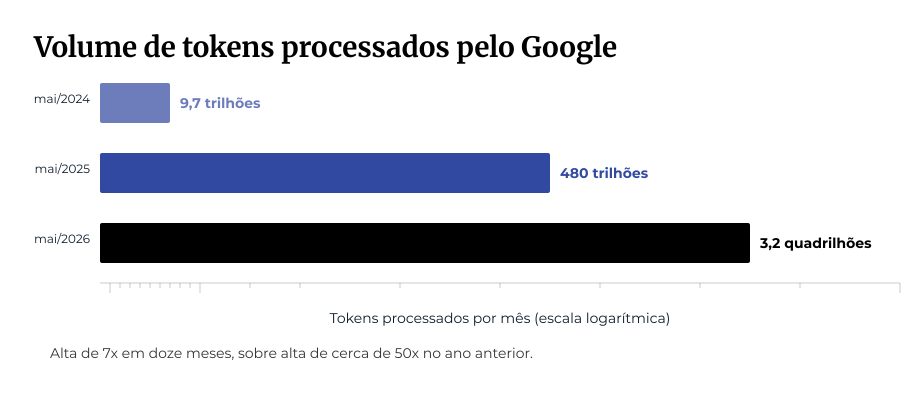
Os números de volume do Google materializam a curva: 9,7 trilhões de tokens por mês em maio de 2024, 480 trilhões em maio de 2025, mais de 3,2 quadrilhões em maio de 2026. Nos doze meses anteriores ao Google I/O de 2026, mais de 375 clientes do Google Cloud processaram, cada um, mais de 1 trilhão de tokens. As APIs de modelo do Google processam aproximadamente 19 bilhões de tokens por minuto.
Duas implicações práticas. A primeira é que planejar com base na queda de preço é errado: se o seu plano é esperar o custo cair, você está apostando contra o seu próprio crescimento de uso. A segunda é que o custo por token deixou de ser a métrica relevante. Quando o preço de um insumo cai três ordens de grandeza em três anos, o que passa a determinar a conta é quantos tokens a sua arquitetura consome para entregar um resultado. Isso desloca a decisão de custo do departamento de compras para dentro do time de engenharia.
Onde o dinheiro vaza
Os padrões abaixo respondem pela maior parte do desperdício encontrado em avaliações de custo de IA. Nenhum deles é exótico, e é justamente isso que incomoda.
Contexto inteiro reenviado a cada chamada, sem cache. O prompt de sistema de 5.000 tokens de um assistente que atende 10.000 conversas por dia gera 50 milhões de tokens por dia só em instruções repetidas, antes de qualquer mensagem de usuário.
Modelo de fronteira usado para tarefa trivial. Classificação, extração de campo e roteamento de intenção não precisam do modelo mais caro do catálogo. A diferença de preço entre a ponta barata e a ponta cara do mercado passa de 100 vezes.
Raciocínio ligado por padrão. Modo de pensamento estendido habilitado globalmente, sem critério por tipo de tarefa, multiplica o custo de saída sem ganho mensurável na maior parte do tráfego.
Saída sem limite. Como a saída custa de 3 a 6 vezes a entrada, pedir “explique detalhadamente” quando bastava um rótulo é uma escolha cara feita em linguagem natural.
Definições de ferramentas carregadas integralmente. Em agentes com bibliotecas grandes, esse overhead domina o prompt, e é evitável com carregamento sob demanda.
Retorno de ferramenta injetado bruto no contexto. Saída de API, HTML de página, resultado de consulta SQL, tudo verbatim. Formatos estruturados reduzem o consumo de forma expressiva.
Troca de modelo no meio da sessão. Muda o modelo, invalida o cache, e o ganho de caching do dia inteiro evapora.
Ninguém sabe qual funcionalidade consumiu o quê. Os painéis dos provedores devolvem um número agregado por dia. Não há recorte por produto, por time ou por cliente. Diretores aprovam faturas que não conseguem decompor. Isso não é ajuste fino: é arquitetura de medição.
Sete estratégias, na ordem do retorno
Organizei as alavancas por retorno sobre esforço, na ordem em que costumam ser aplicadas.
Estratégia 1: instrumentar antes de otimizar
Nada aqui funciona sem atribuição. Antes de mexer em modelo, prompt ou cache, você precisa conseguir responder quanto custou cada funcionalidade, cada time e, idealmente, cada cliente.
Na prática, isso significa um gateway de LLM na frente dos provedores, com identificadores obrigatórios de produto, time e caso de uso em cada requisição. Ferramentas como LiteLLM, Portkey e OpenRouter resolvem a parte técnica. A parte difícil é a taxonomia, e ela é uma decisão organizacional. Sem número por funcionalidade, toda otimização vira anedota.
Estratégia 2: cache de prompt
O desconto mais alto disponível hoje, e o menos utilizado. Os três principais provedores oferecem cache de prompt, que armazena os tensores de chave e valor já computados para um prefixo repetido. Leituras em cache custam 10% do preço base de entrada na Anthropic e nos modelos recentes da OpenAI e do Google.
A regra que decide se funciona ou não é uma só: conteúdo estático antes, conteúdo dinâmico depois. Se a parte variável do prompt estiver no início, o cache nunca acerta.
De US$ 720 para US$ 72
na fatura mensal de um agente de análise de causa raiz sobre Claude após três marcadores de cache.
Mesmo agente, mesmo modelo. Só o prefixo estático passou a ser cacheado.
Estratégia 3: roteamento de modelos
A ideia é enviar cada requisição ao modelo mais barato capaz de resolvê-la, em vez de pagar preço de fronteira para todo o tráfego. O trabalho acadêmico de referência é o RouteLLM, apresentado no ICLR de 2025, que demonstrou manter cerca de 95% da qualidade do modelo de fronteira enviando apenas de 14% a 26% das chamadas para o modelo forte, com redução de custo entre 75% e 85% no tráfego roteado.
Estimativas de mercado apontam que cerca de 85% das consultas corporativas podem ser atendidas por modelos de menor custo sem queda perceptível de qualidade. Sem um conjunto de avaliações automatizadas, roteamento é aposta.
Estratégia 4: processamento assíncrono e lote
Os três provedores oferecem 50% de desconto para APIs de lote, com resultado devolvido em horas em vez de segundos. Qualquer carga que tolere latência deveria estar ali: enriquecimento de base, classificação retroativa, geração de resumos noturnos, avaliação de qualidade, indexação.
Os descontos se acumulam. A Anthropic documenta que lote e cache se multiplicam: lote a 50% sobre leitura em cache a 10% resulta em 5% do preço de tabela de entrada. Na maioria das operações analisadas, entre 30% e 50% do tráfego realmente precisa de resposta em tempo real.
Estratégia 5: disciplina de contexto
Pode o histórico em vez de reenviar tudo. Resumos progressivos custam muito menos que transcrições completas.
Recupere seletivamente. RAG que despeja vinte documentos no contexto porque “é melhor sobrar” é a versão moderna do overprovisioning de CPU.
Sumarize retornos de ferramenta antes de injetar no contexto. Estruture a saída com esquemas JSON e sequências de parada claras. Carregue definições de ferramentas sob demanda.
Estratégia 6: governar o raciocínio
Trate o modo de raciocínio como um recurso caro que precisa de autorização, não como configuração padrão. Na prática, isso vira uma política escrita: raciocínio estendido habilitado para análise de contrato, diagnóstico de incidente e decisão arquitetural; desabilitado para classificação, extração, roteamento e resposta a pergunta frequente.
O estudo sobre tarefas agênticas de programação encontrou um achado contraintuitivo: consumo maior de tokens não se traduziu em desempenho melhor. A evidência disponível não sustenta a crença de que mais pensamento produz melhor resultado, e ela sai cara.
Estratégia 7: custo por resultado, não por token
Custo por milhão de tokens é uma métrica de fornecedor. A métrica de negócio é custo por resultado entregue: por ticket resolvido, por documento processado, por proposta gerada, por transação analisada.
A Intercom cobra pelo agente Fin com base em resultado, a 0,99 dólar por resolução. Estudos de caso publicados pela própria Intercom mostram taxas reais de resolução entre 42% e 50%. A Zendesk seguiu com modelo próprio por resolução, partindo de 1,00 dólar em volume comprometido.
Empresas de IA operam com margem bruta de 50% a 60%, contra 80% a 90% de SaaS tradicional, segundo a Bessemer Venture Partners. A diferença é tudo o que existe em volta do token: recuperação, indexação, revisão humana, observabilidade, infraestrutura.
O efeito composto
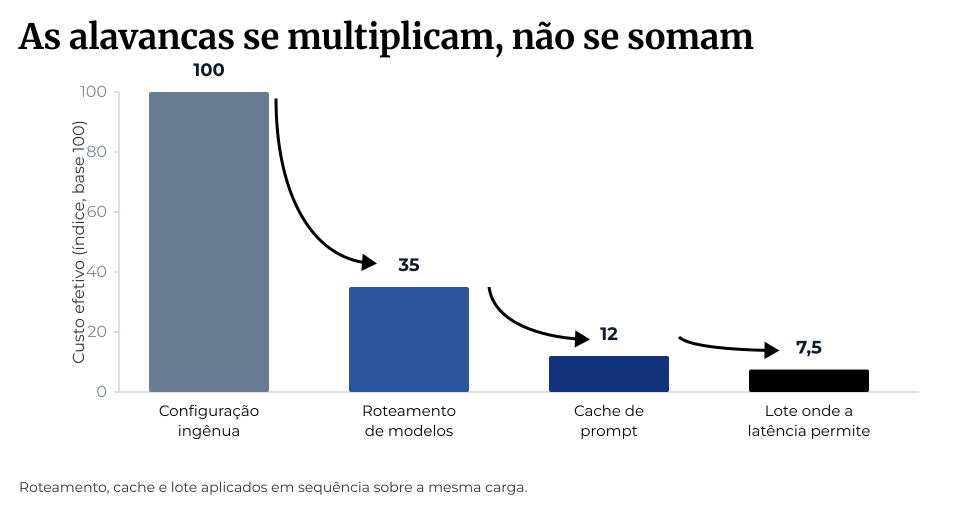
As alavancas se multiplicam. Um mesmo volume de trabalho, roteado para um modelo adequado, com cache no prefixo estático e processamento em lote onde a latência permite, custa uma fração do que custaria na configuração ingênua.
Um exemplo documentado: uma implantação corporativa reduziu a fatura mensal de 47.000 para 12.700 dólares, queda de 73%, substituindo cache de correspondência exata por cache semântico e elevando a taxa de acerto de 18% para 67%.
Como medir: o que a diretoria deveria olhar
Custo total de IA por mês é a métrica menos útil que existe. Ela sobe quando o negócio cresce e desce quando o negócio encolhe, o que a torna inútil para decidir qualquer coisa. O que funciona é um conjunto pequeno de indicadores.
| Indicador | O que responde |
|---|---|
| Custo por resultado de negócio | Se a economia unitária fecha |
| Custo por mil tokens efetivo | Se as alavancas de otimização estão funcionando |
| Taxa de acerto de cache | Se a maior alavanca disponível está sendo usada |
| Distribuição de tráfego por camada de modelo | Se o roteamento está calibrado |
| Proporção de tokens de raciocínio sobre saída | Se o pensamento está sendo governado |
| Variância de custo por execução | Qual o risco real da projeção orçamentária |
| Margem bruta da funcionalidade de IA | Se o produto se sustenta |
Sobre variância: o dado de 30 vezes de diferença entre execuções da mesma tarefa agêntica deveria mudar a forma como se orça IA. Média não descreve essa distribuição. Trabalhe com percentis, e converse sobre p95, não sobre média, quando for definir teto de gasto.
Noventa dias para sair do escuro
01 a 30: visibilidade
Coloque um gateway na frente dos provedores. Defina a taxonomia de atribuição por produto e time. Meça o tokenizer sobre o seu texto real em português. Publique o primeiro relatório de custo por funcionalidade, mesmo imperfeito, e diga que é imperfeito.
31 a 60: ganhos rápidos
Reestruture os prompts colocando conteúdo estático antes do dinâmico e ative cache. Identifique as três funcionalidades de maior volume e teste roteamento para modelo de camada inferior, com avaliação automatizada medindo a qualidade. Mova para lote tudo o que tolera latência. Defina limites de saída. Essa fase costuma pagar o projeto inteiro.
61 a 90: estrutura
Escreva a política de raciocínio por tipo de tarefa. Implemente poda de contexto e sumarização de retorno de ferramenta. Estabeleça orçamento por time com alerta de anomalia. Publique as primeiras métricas de custo por resultado de negócio, e leve para a mesma reunião a engenharia e o financeiro.
O indicador de que deu certo não é a fatura ter caído. É existir um número de custo por unidade de negócio que as duas áreas olham juntas e concordam que está correto.
Cinco erros que repetem a fatura
- Comprar ferramenta de FinOps para IA antes de definir a taxonomia de atribuição. O painel fica bonito e a fatura fica igual.
- Otimizar antes de medir. Sem linha de base, você não sabe se melhorou, e não consegue defender o resultado.
- Projetar orçamento com dados em inglês. Some de 30% a 50% para português e refaça a conta.
- Tratar o preço de tabela como o preço real. Entre cache, lote e roteamento, o preço efetivo de uma operação bem construída fica em uma fração da tabela.
- Adiar por causa da deflação. O preço por token vai continuar caindo, e a sua conta vai continuar subindo, porque o volume cresce mais rápido.
Antes de fechar esta página
Tokenomics é uma daquelas disciplinas em que conhecimento técnico isolado não resolve. É preciso alguém que entenda de cache de prefixo e orçamento de tokens de raciocínio, e que também consiga sentar com a diretoria financeira e explicar por que a métrica de custo por token deveria sair do relatório e dar lugar a custo por resultado.
Você sabe quanto custa cada funcionalidade de IA em produção, ou só a fatura agregada do mês?
O orçamento foi projetado com texto real em português, ou com benchmark em inglês?
Cache de prompt está ativo onde o prefixo é estático, e o conteúdo dinâmico vem depois?
Raciocínio estendido é política por tipo de tarefa, ou configuração padrão global?
A conversa com a diretoria usa custo por resultado de negócio, ou ainda gira em torno de custo por milhão de tokens?
- Linux Foundation. Anúncio de intenção de criação da Tokenomics Foundation e Tokenomicon, junho de 2026.
- FinOps Foundation. Token Economics: The Atomic Unit of AI Value; cobertura do FinOps X 2026.
- Andreessen Horowitz. Welcome to LLMflation.
- Epoch AI. Tendências de preço de inferência de LLM.
- Menlo Ventures. 2025: The State of Generative AI in the Enterprise.
- Google. Discurso de abertura de Sundar Pichai no Google I/O 2026.
- arXiv. How Do AI Agents Spend Your Money? (2604.22750); Token Economics for LLM Agents (2605.09104); AI Tokenomics (2606.24616); Language Model Tokenizers Introduce Unfairness Between Languages (2305.15425).
- Ong et al. RouteLLM: Learning to Route LLMs with Preference Data. ICLR 2025.
- Anthropic, OpenAI e Google. Documentação de preços, cache e APIs de lote.
- Intercom e Bessemer Venture Partners. Precificação por resultado do agente Fin; dados de margem bruta de empresas de IA.
Os preços e valores citados refletem informação pública disponível até julho de 2026 e mudam com frequência. Valide na documentação do provedor antes de usar em modelo financeiro.

Vamos entender o próximo passo juntos?
Fale com um especialista da eximia.co sobre arquitetura, engenharia e tecnologia.